Le prochain processeur très haut de gamme d'AMD pour PC portable pourrait intégrer sa propre mémoire vidéo GDDR7 dédiée. Une excellente nouvelle pour jouer sans carte graphique séparée, mais un potentiel retour en arrière pour faire tourner d'immenses modèles d'IA en local.
Pour le Black Friday 2026, processeurs, cartes graphiques, boîtiers PC, stockage et alimentation sont en promotion chez plusieurs e-commerçants, généralistes ou spécialisés. Voici une sélection d'une quinzaine d'offres en espérant qu'elle puisse vous aider à monter votre PC maison, surtout dans cette économie.
Besoin de remplacer une tour vieillissante ou de donner un bon coup de fouet à votre équipement avec une nouvelle machine ? Materiel.net a ce qu’il vous faut avec le Wyvern, une configuration 100 % AMD, taillée pour le jeu en 4K et disponible à prix réduit pour le Black Friday.
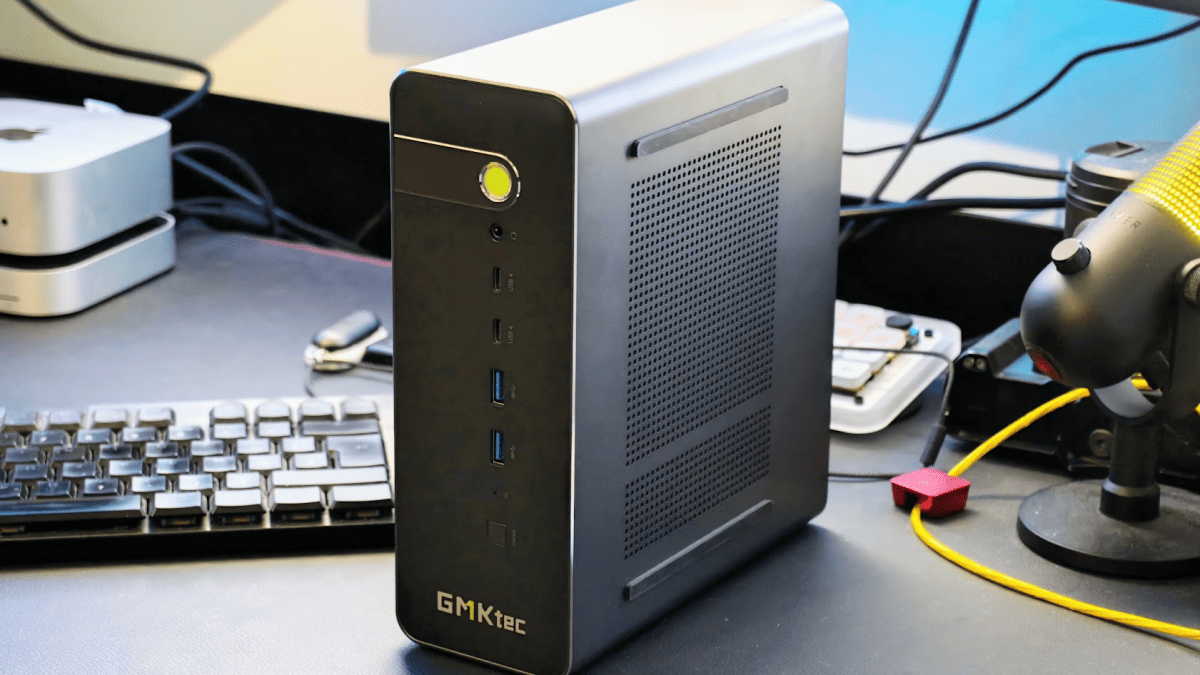
Le GMKtec EVO-X5 Pro est l'une des premières machines équipées du Ryzen AI Max+ PRO 495, la mise à jour de la puce Strix Halo d'AMD. Le processeur progresse à peine, mais la mémoire passe de 128 à 192 Go. Assez pour faire tourner chez soi des modèles d'IA qu'aucun mini PC ne chargeait jusqu'ici.
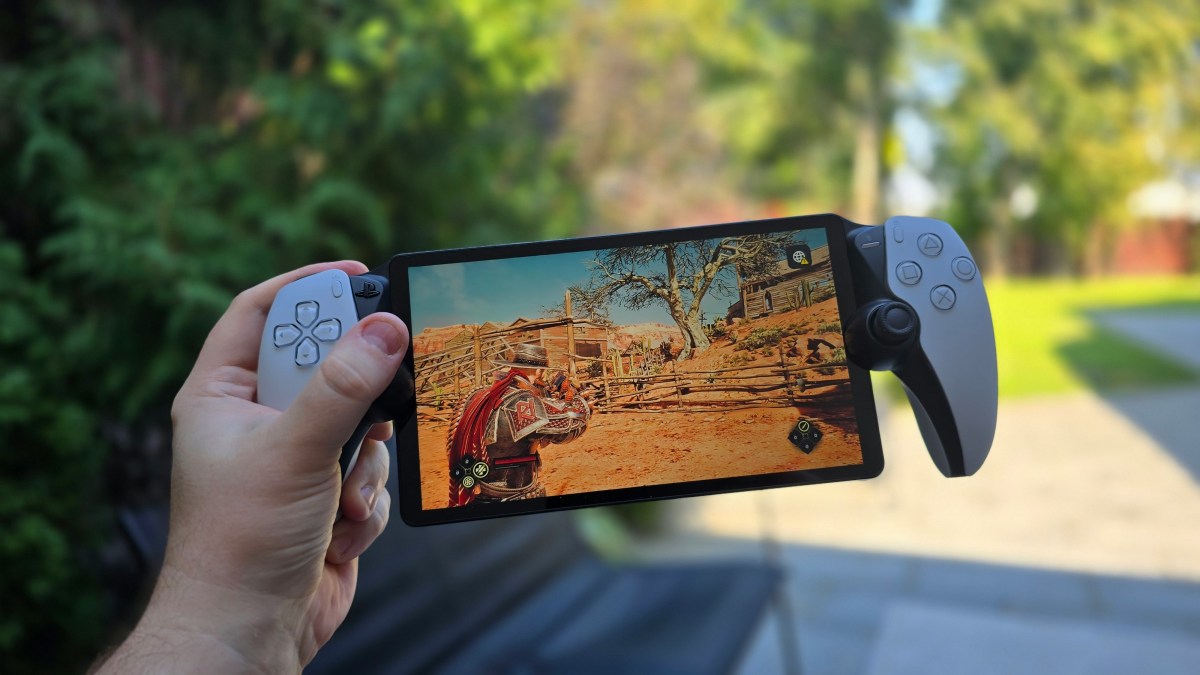
Richard Leadbetter, de Digital Foundry, affirme que Sony aurait « une forme d'exclusivité » sur RDNA 5, la future architecture graphique d'AMD, pour sa prochaine console portable. Il le dit dans un épisode réservé aux abonnés, et ni Sony ni AMD n'ont confirmé.
Modal, un fournisseur cloud spécialisé dans l'IA, va ajouter des processeurs Nvidia Vera à ses serveurs. Dans ses tests internes, ils ont traité jusqu'à deux fois plus de tâches que ses puces Intel. Jusqu'ici, sa flotte tournait uniquement sur des processeurs x86 d'Intel et AMD.
Intel facture depuis le 1er septembre 2026 jusqu'à 20 % plus cher ses processeurs Panther Lake les plus puissants aux fabricants de PC portables, d'après le quotidien taïwanais Commercial Times. Ce serait la troisième hausse de prix d'Intel depuis fin 2025.
Alors ça c'est fou mais fallait s'y attendre... Un joueur allemand a acheté un processeur
Ryzen 7 5800X3D
d'occasion (lien affilié), l'a monté dans son PC, puis a lancé Valorant ! Selon ce qu'il explique sur Reddit, il s'est alors fait virer du jeu de Riot dès le tout premier lancement ! Problème de compte ? Que nenni ! En fait il s'est fait dégagé à cause du processeur car son premier propriétaire était un tricheur !
D'après
Heise
, le support de Riot lui a bien confirmé que l'ancien propriétaire trichait. Du coup, le CPU s'est retrouvé sur une liste noire chez eux, ainsi que la carte mère et le stockage. Et bien sûr, on peut venir chialer au support, Riot ne retirera pas ce matériel banni de ses listes à la main. Sans parler du fait que le blocage est global pour tous les jeux PC de l'éditeur comme League of Legends, Teamfight Tactics, Legends of Runeterra et 2XKO.
Ce type de sanction
vise donc les composants physiques de la machine, en plus du compte et malheureusement, tout autre compte qui s'y connecte est donc instantanément bloqué sur cet appareil et banni puisque le système suppose qu'il s'agit là d'une tentative de contournement. Pour votre culture G, sachez que l'erreur qui s'affiche s'appelle VAN 152, et réinstaller le jeu n'y changera rien.
Reste maintenant à savoir comment Riot reconnaît un processeur précis... L'identifiant qu'un CPU remonte à Windows ne donne que son modèle, donc un 5800X3D ressemble à n'importe quel autre 5800X3D mais il est possible que le système anti triche extrapole une empreinte à partir du comportement électrique de la puce (fréquences, tensions), ou récupère les identifiants inscrits dans le
TPM
.
La seconde option me semble la plus logique, car sur un Ryzen, le TPM n'est pas une puce à part. C'est plutôt un firmware, le fTPM, intégré au processeur, et Riot exige un TPM firmware pour les comptes sous restriction. Ça ne prouve pas encore qu'il s'en servent pour identifier le matériel, en 2021
PC Gamer
expliquait que le TPM empêcherait un tricheur Valorant banni de se refaire un identifiant matériel tout neuf, donc ça se tiendrait...
Alors faut-il pour autant fuir le matériel d'occasion ?
Je ne pense pas qu'il faille flipper non plus parce que ce cas de figure semble extrêmement rare. Tous les tricheurs ne se font pas choper, et tous les tricheurs ne vendent pas leur matériel en occaz... Mais le risque n'est pas nul et il n'y a pas vraiment moyen de savoir si une pièce a été marquée, sauf si le vendeur-tricheur le dit.
Bref, si vous voyez apparaître un VAN 152 juste après avoir installé du matos d'occasion, n'allez surtout pas tester le jeu avec un autre compte car il serait lui aussi banni. Vaut mieux ouvrir un ticket pour demander une réévaluation à Riot qui apparemment a prévu le coup mais sans toutefois le garantir... La preuve avec notre joueur allemand qui s'est fait jeter par le support... J'ignore comment ça s'est fini pour lui mais vu la médiatisation de toute cette affaire, j'espère que Riot a fait un geste !
Dans la course à l’IA, sans doute plus qu’ailleurs, les acquisitions sont un moyen de gagner du temps et de recruter des talents.
Depuis 2022, AMD a bâti par acquisitions une chaîne de valeur allant des semi-conducteurs adaptatifs aux réseaux, en passant par les logiciels d’inférence, les modèles d’IA et les infrastructures de data centers.
L’acquisition de World Labs pour environ 8,2 milliards $, entièrement payée en actions, marque un nouveau cap. AMD ne vise plus seulement les processeurs et les systèmes mais aussi l’expertise en modèles et en recherche
Ce laboratoire d’IA fondé et dirigé par Fei-Fei Li, professeure à Stanford et figure majeure de l’IA, lui offre un accès direct à des expertises en modèles d’IA et en intelligence spatiale, au moment où les besoins de calcul s’étendent au-delà des modèles de langage.
Connue pour ses recherches sur la vision par ordinateur et pour sa défense d’une IA « centrée sur l’humain », Fei-Fei Li a fondé World Labs en 2024 afin de travailler sur des modèles capables de comprendre et de représenter l’espace physique en trois dimensions. Elle rejoindra AMD comme vice-présidente exécutive et Chief Scientist, rattachée à sa CEO Lisa Su.
La transaction est évaluée à environ 8,2 milliards de dollars et prendra la forme d’un échange d’actions. AMD indique que la clôture est prévue avant la fin de 2026, sous réserve des autorisations réglementaires et des conditions habituelles de clôture.
Ce que fait World Labs
Basé à San Francisco, World Labs développe des modèles d’intelligence spatiale capables de générer, reconstruire et simuler des environnements 3D interactifs à partir de textes, d’images ou de vidéos. Le laboratoire travaille également sur des technologies destinées à l’apprentissage et à la simulation pour la robotique.
Ce positionnement diffère de celui des principaux laboratoires centrés sur les grands modèles de langage. AMD met en avant l’émergence de cas d’usage liés au raisonnement, à la robotique, à la simulation et à « l’IA physique », des domaines qui imposent des profils de charge et des exigences d’infrastructure plus variés.
Lisa Su souligne que la construction des plateformes de calcul de la prochaine génération d’IA « nécessite une compréhension approfondie de l’évolution des modèles ». Fei-Fei Li évoque pour sa part l’accès aux ressources et à la profondeur d’ingénierie d’AMD pour accélérer les recherches de World Labs et définir l’infrastructure nécessaire à la prochaine ère de l’IA.
Elle pourrait aussi renforcer son l’ambition de fournir une infrastructure d’IA pour un écosystème ouvert. Un positionnement qui s’oppose implicitement aux approches plus intégrées de certains acteurs du marché.
World Labs évolue sur le même créneau que AMI Labs, la start-up fondée par Yann LeCun après son départ de Meta. Elles développent des « world models » et une IA capable de comprendre et d’agir dans le monde physique. World Labs privilégie toutefois l’intelligence spatiale et la génération ou simulation d’environnements 3D, quand AMI Labs défend une approche plus large de l’intelligence machine, associant mémoire, raisonnement, planification et sécurité.
Les principales acquisitions d’AMD dans le domaine de l’IA
Année
Cible
Domaine
Montant annoncé / réalisé
Apport pour AMD
2022
Xilinx
FPGA, SoC adaptatifs, accélérateurs
Environ 49 milliards USD
Élargit le portefeuille au-delà des CPU et GPU, vers le calcul adaptatif et l’embarqué.
2022
Pensando Systems
DPU, réseau data center
1,9 milliard USD
Renforce les capacités réseau et le traitement de données pour le cloud et l’infrastructure.
2023
Mipsology
Logiciels d’inférence IA
Non communiqué
Renforce les capacités logicielles d’inférence sur les architectures AMD.
2023
Nod.ai
Logiciels IA open source
Non communiqué
Vise à améliorer la pile logicielle ouverte, un axe central face à l’écosystème Nvidia.
2024
Silo AI
Laboratoire d’IA, modèles open source
665 millions USD
Apporte des compétences en modèles de langage multilingues et en déploiement de solutions IA sur le matériel AMD.
2024–2025
ZT Systems
Infrastructure de serveurs et data centers
4,9 milliards USD annoncés ; 4,4 milliards USD de contrepartie comptabilisée à la clôture
Donne à AMD une expertise systèmes et rack-scale pour les solutions d’IA de bout en bout. AMD a conservé les activités de conception, puis cédé en 2025 l’activité de fabrication à Sanmina pour 2,4 milliards USD.
2025
Enosemi
Photonique silicium, optique copackagée
Non communiqué
Soutient le développement de solutions optiques pour les futures générations de systèmes IA.
2025
Brium
Compilateurs et logiciels
Non communiqué
Renforce la pile logicielle et les outils de développement.
2025
Équipe d’Untether AI
Conception de puces IA
Non communiqué
Apporte des compétences en conception de silicium pour l’IA.
2026
World Labs
Modèles d’IA, intelligence spatiale, IA physique
Environ 8,2 milliards USD, en actions
Ajoute une équipe de recherche dirigée par Fei-Fei Li et des expertises sur les modèles capables de représenter et simuler des environnements 3D. Opération annoncée, non encore finalisée.
DLSS-NR on AMD
est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD.
Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer. Nvidia l'a mis en place sur
NBA 2K27
en partenariat avec Visual Concepts et 2K, alors que le mod DLSS-NR on AMD l'applique déjà à Cyberpunk 2077, qui n'a pourtant pas été conçu pour ça. Je me rappelle quand même que la démo du DLSS 5 avait été
très mal accueillie en mars
parce qu'elle donnait l'impression d'écraser la direction artistique des jeux mais on dirait que ça passe un peu mieux aujourd'hui... Soit les gens se sont habitués, soit le logiciel fait du meilleur taf, je ne sais pas.
D'après le README du projet, pour installer ça sur votre ordi, vous devez placer le programme d'install de la dernière release dans le dossier de l'exécutable du jeu (bin\x64 pour Cyberpunk 2077), à côté
d'une DLL de Nvidia
. Ensuite vous le lancez, puis vous démarrez le jeu et activez le FSR. La touche Fin ouvrira alors l'overlay du mod, et si vous voulez mettre à jour tout ça ou le virer, il suffit de relancer l'installateur.
Il faut aussi Windows 11 et le pilote Adrenalin 26.1.1 ou plus récent et comme les jeux avec anti-triche bloquent la DLL, vaut mieux pas vous lancer en multi avec ce mod.
Par contre, sachez-le, les résultats en termes de FPS ne sont pas toujours au rendez-vous si j'en crois les benchmarks publiés sur les pages du projet.
Maintenant à vous de voir si vous faites confiance à ce mod puisque le code n'est pas publié. Notez que 2 autres projets similaires pourraient également vous intéresser... Il y a
lmxxf
, sous licence MIT qui se limite aux RX 9000 et embarque les poids de Nvidia extraits d'une copie locale de la DLL. Et aussi
AMDNR
de 3zwr1 qui est intégré à OptiScaler.
Mais en tout cas, si vous essayez DLSS-NR on AMD sur une RX 7000, sachez que son auteur demande des retours donc n'hésitez pas à lui envoyer votre fichier dlssnr_on_amd.log si vous rencontrez des bugs.
Cet article a été réalisé en collaboration avec Cybertek
Avec la configuration Gungnir, Cybertek fait le choix d’une fiche technique unifiée autour de composants AMD. Une décision pragmatique qui vise à tirer pleinement parti des interactions poussées entre CPU, GPU et optimisations logicielles maison.
Cet article a été réalisé en collaboration avec Cybertek
Il s’agit d’un contenu créé par des rédacteurs indépendants au sein de l’entité Humanoid xp. L’équipe éditoriale de Numerama n’a pas participé à sa création. Nous nous engageons auprès de nos lecteurs pour que ces contenus soient intéressants, qualitatifs et correspondent à leurs intérêts.
AMD est devenu le quatrième fabricant américain de semi-conducteurs à dépasser les 1 000 milliards $ de valorisation boursière, porté par un bond de près de 10% de son action en séance.
Le titre a atteint un plus haut historique à 615,52 $, avant de clôturer en hausse de 9,6% à 613,31 $, le 21 septembre.
Cette performance place AMD aux côtés de Nvidia, Broadcom et Micron, seuls autres groupes américains du secteur à avoir déjà atteint ce seuil.
Le groupe ne se contente plus de vendre des puces individuelles mais propose désormais des systèmes complets associant processeurs, équipements réseau et matériels connexes.
Le groupe californien profite également de la demande croissante pour les processeurs centraux utilisés en complément des puces graphiques dans les serveurs dédiés à l’inférence, un segment sur lequel il grignote des parts de marché à Intel.
Les résultats du deuxième trimestre, publiés début août, avaient déjà illustré cette dynamique : le chiffre d’affaires avait atteint 11,54 milliards $, en hausse de 50% sur un an, porté par une division Data Center en croissance de 107%, à 6,7 milliards $.
Vous avez une carte Radeon dans le PC, et un logiciel boosté à l'IA qui refuse de se lancer ailleurs que sur de la NVIDIA ? Roooh c'est dommage ! Cet outil vous réclame probablement CUDA en dur et malheureusement, personne n'ira faire une version fonctionnelle pour votre carte AMD.
Alors on fait quoi ? On se roule en boule et on chiale ? Bah non, on installe
CUDA-for-AMD-Windows
comme des guerrier(e)s et on avance dans la vie !
Ce projet est assez unique puisqu'il n'écrit pas une seule ligne de traduction CUDA. En réalité c'est un jeu de scripts PowerShell qui monte la pile à votre place avec
ZLUDA
d'un côté, qui fait le travail de traduction depuis des années, et le
HIP SDK d'AMD
de l'autre, qui fournit les bibliothèques de calcul.
Car c'est justement ce qui manquait sous Windows. Le pilote Adrenalin vous donne le runtime, mais pour le reste de ROCm, demmerdez-vous entre un SDK officiel en retard et des compilations nocturnes buggées... Breeeeef.
Du coup, ce script d'installation fait ce tri pour vous. Il repère votre carte et son architecture gfx, vérifie que le pilote AMD et le HIP SDK sont là, télécharge une version précise de ZLUDA et, si votre programme en a besoin, LibTorch. Il compare les empreintes SHA-256 des archives, et finit en lançant le contrôle de ZLUDA sur votre machine. Une fois les prérequis AMD en place, ça tient ensuite en trois lignes :
git clone https://github.com/Speedstu/CUDA-for-AMD-Windows.git
cd CUDA-for-AMD-Windows
powershell -ExecutionPolicy Bypass -File .\scripts\install.ps1
Prévoyez quand même de la place car ce bon vieux LibTorch pèse 2,66 Go à lui seul. Notez quand même qu'un -SkipLibTorch vous en dispensera si votre logiciel ne s'en sert pas. Après ça, vous lancez votre exécutable avec run-zluda.ps1, qui pose les DLL de compatibilité à côté de lui, met les bibliothèques HIP sur le PATH et passe la main à zluda.exe.
cuBLAS, cuBLASLt, cuSPARSE et cuFFT, sont donc bien redirigés vers rocBLAS, hipBLASLt et rocSPARSE, mais pas cuDNN...
En effet, le HIP SDK Windows stable ne fournit pas la pile IA complète de ROCm, celle qu'on a sous Linux, et les contrôles cuDNN de ZLUDA se plantent sans un backend compatible MIOpen. Donc si le logiciel que vous voulez lancer tape lourdement dans les convolutions, faudra vous arrêter là. NCCL, TensorRT ou une extension CUDA maison peuvent échouer aussi...
Bref, l'auteur ne promet rien de magique ni d'universel mais ça se tente quand même selon ce que vous voulez lancer.
Ajoutez à ça qu'une seule carte est validée, la Radeon RX 9060 XT, et qu'une seule appli est réellement passée de bout en bout. On est donc sur de l'hyper expérimental
Voilà, avant de vous lancer là-dedans, regardez si vous en avez vraiment besoin car AMD a fini par apporter un support officiel de PyTorch et du HIP SDK à Windows, avec les composants ROCm 7.2.1. Sa
matrice de compatibilité
indique que côté grand public, la RX 9060 XT justement, mais aussi les RX 9070, la RX 7900 XTX et la RX 7700 sont supportés. Si votre besoin c'est donc PyTorch, moi je prendrais cette route-là à votre place car elle est native.
À récupérer sur GitHub si vous avez un logiciel qui refuse de démarrer à cause de CUDA.
AMD étoffe son portefeuille dans l’IA avec le rachat de Taalas, une start-up basée à Toronto et fondée en 2023. La transaction reste soumise aux conditions de clôture habituelles et aux autorisations réglementaires.
Taalas développe des composants en silicium spécialisés pour l’inférence IA. À la différence de l’entraînement, qui mobilise d’importantes capacités de calcul pour construire un modèle, l’inférence intervient lors de son utilisation opérationnelle, souvent en temps réel.
La technologie de Taalas vise à réduire les goulets d’étranglement liés au calcul et à la mémoire dans les architectures généralistes. La start-up conçoit notamment des accélérateurs adaptés à des modèles spécifiques, en intégrant directement certains paramètres du modèle dans le silicium.
Cette approche permet de gagner en performance et en efficacité énergétique, au prix d’une flexibilité moindre qu’avec un GPU généraliste. Les accélérateurs de Taalas sont configurés pour un modèle donné et peuvent donc être beaucoup plus rapides et moins coûteux dans des scénarios d’usage ciblés. Mais ils doivent être adaptés lorsque le modèle évolue.
Le premier composant de Taalas ferait fonctionner une version allégée de Llama 3.1, le modèle de Meta.
Une brique supplémentaire pour AMD
AMD prévoit d’intégrer la technologie de Taalas dans sa feuille de route d’accélérateurs et entend également développer des solutions au niveau système combinant ces technologies avec ses GPU Instinct.
L’opération doit ainsi compléter la plateforme IA full stack d’AMD, qui comprend les solutions rackscale Helios, les accélérateurs Instinct, les processeurs EPYC, le logiciel ROCm et les composants de son écosystème logiciel et matériel.
Pour AMD, l’enjeu consiste à proposer plusieurs types de processeurs selon les charges de travail. Les GPU restent adaptés à une grande variété de modèles et d’usages tandis que des accélérateurs spécialisés peuvent être pertinents pour des modèles stabilisés exécutés à très grande échelle. Par exemple dans les moteurs de recherche, les assistants conversationnels ou les services de génération de contenu.
Cette acquisition intervient alors que le marché de l’IA se déplace progressivement de l’entraînement des modèles vers leur déploiement massif. Les fournisseurs de cloud et les grandes entreprises cherchent désormais à réduire le coût et la consommation énergétique de milliers, voire de millions, de requêtes quotidiennes.
Cette évolution ouvre la voie à des architectures plus spécialisées. Les GPU offrent une grande souplesse mais leur coût et leur consommation peuvent devenir pénalisants lorsque les modèles sont exécutés de manière répétitive et prévisible. Les ASIC et autres accélérateurs dédiés tentent de répondre à cette contrainte en optimisant le matériel pour un modèle ou une famille de modèles.
La bataille de l’inférence s’intensifie
Nvidia a renforcé sa présence sur ce segment en dévoilant, notamment, un processeur et un système d’IA s’appuyant sur la technologie de Groq, une start-up spécialisée dans l’inférence.
La pression concurrentielle ne vient toutefois pas uniquement des deux géants des GPU car les hyperscalers développent également leurs propres puces, à l’image des accélérateurs conçus pour leurs infrastructures cloud.
Pour AMD, le principal défi sera d’intégrer cette technologie dans une offre industrielle et logicielle cohérente. Une puce spécialisée peut afficher des performances très élevées sur un modèle donné, mais son intérêt dépend de la stabilité des architectures d’IA, de la capacité à reconfigurer rapidement le matériel et de la compatibilité avec les outils de développement existants.
L’intégration avec Instinct et ROCm sera donc déterminante. AMD devra démontrer que Taalas peut compléter ses GPU plutôt que constituer une technologie isolée, difficile à programmer ou limitée à quelques cas d’usage.
La carte graphique minimum dont on a besoin pour émuler une PS3 est sortie... après la PS3. C'est AniLeo et kd-11, de l'équipe
RPCS3
, qui viennent de descendre le minimum officiel de l'émulateur à la Radeon HD 2900 XT, sortie en mai 2007. La PS3, elle, arrivait en France en mars de la même année.
Certes, c'est moins de deux mois d'écart mais pour émuler une console, en général, on a besoin de matériel largement postérieur.
RPCS3 accepte donc maintenant les Radeon HD 2000, 3000 et 4000, la première génération TeraScale d'ATi. Le plancher précédent, c'était la HD 5550. Deux conditions quand même : ça ne marche que sous Linux, avec le pilote libre Mesa r600. Windows reste dehors, le vieux pilote d'AMD étant trop bancal pour l'émulateur.
Maintenant, ce qui bloquait vraiment n'était pas la puissance. L'émulateur tenait pour acquis que toutes les cartes qu'il supporte savent faire un certain type d'écriture en mémoire. Ces vieilles Radeon ne savent pas, et personne n'avait prévu le cas, alors l'affichage plantait dès le démarrage, sur un pointeur nul... snif. Le correctif consiste donc à vérifier si la carte sait le faire, et à s'en passer quand ce n'est pas le cas. Et voilà, une pull request plus tard et c'était du tout bon pour la Radeon HD 2900 XT !
Reste que la plus musclée de ces vieilles puces, la HD 4890 de 2009 avec son gigaoctet de mémoire, donne des résultats à géométrie très variable. Sur les captures de l'équipe, OutRun Online Arcade tourne entre 52 et 59 fps, et Metal Gear Solid HD Collection oscille entre 45 et 60 selon la densité de la scène. Jusque-là, ça va.
Par contre, la démo de FIFA 08 tombe à 15 fps, et le jeu Rain à 15 aussi, et là c'est la cata. Cette HD 4890 est pourtant plusieurs fois plus puissante que le RSX, la puce graphique de la PS3, mais ça ne suffit pas, parce que l'émulateur lui refile du boulot que la console ne lui demandait pas, comme décoder les textures à la place du processeur. Et surtout, parce que la mémoire n'est pas rangée pareil.
Sur PS3, la mémoire vidéo et la mémoire système sont bien deux réservoirs séparés, sauf que les jeux ont le droit de piocher directement dans les deux. Tout est à portée de main. Sur PC, les deux sont vraiment cloisonnés, du coup l'émulateur passe son temps à recopier les données de l'un vers l'autre.
En descendant dans la gamme, la sanction est immédiate. La HD 3870 doit tomber à 273p, l'équivalent d'une PSP, pour afficher les jeux les plus simples. La HD 2600 XT, elle, plafonne à 12,9 fps sur Portal à cette même définition. Bref, ça ne sert plus à rien de descendre plus bas, celle-là est carrément plus faible que la puce de la console qu'elle est censée émuler.
Côté manipulation, il faut mentir au pilote. Ces cartes annoncent une version d'OpenGL trop ancienne, et l'émulateur refuse de démarrer tant qu'il la voit. Deux variables d'environnement au lancement suffisent à lui faire croire le contraire :
Et si ça plante encore, l'équipe conseille de basculer le réglage Shader Mode sur "Legacy Recompiler".
Je vous parlais de RPCS3 en 2021
quand il servait surtout à rendre les vieux jeux plus beaux avec le FSR d'AMD et voilà maintenant qu'il sait les faire tourner sur du matériel de leur époque.
Le billet de l'équipe
, que je vous invite à lire, détaille les réglages et les résultats carte par carte. Si vous avez une TeraScale au fond d'un placard, vous savez quoi en faire.
Ne dites plus TDP, mais « puissance CPU par défaut ».
Avec ses puces EPYC de 6e génération (« Venice »), AMD a fait la bascule. Il communique ce nouvel indicateur qui reflète la consommation cumulée calcul + I/O pour une cible de performance donnée.
Jusqu’à 256 cœurs avec EPYC Venice
Les CPU Venice utilisent des cœurs Zen 6 et 6c. Ils se répartissent en quatre familles.
Dans le haut du panier, les EPYC 9006 SP7 (9 références) vont de 64 à 256 cœurs physiques, pour 300 à 600 W de puissance par défaut. Ils sont attendus au T4 2026.
Prévus pour S1 2027, les EPYC 9006 SP8 (22 SKU) se destinent à des environnements plus restreints, avec 8 à 128 cœurs physiques et 130 à 400 W de puissance par défaut.
La série 9006X SP7 cible le HPC, avec davantage de cache L2 que les 9006 SP7 et une fréquence maximale portée à 5,15 GHz. Quant aux 9006 LP (basse consommation ; ex-Verano), ils visent les nœuds de tête au sein des architectures agentiques.
Un GPU Instinct à l’intersection de l’IA et du HPC
Lancée en parallèle des EPYC Venice, la gamme de GPU Instinct MI400 comprend pour le moment deux modèles.
D’un côté, le MI455X, doté de 432 Go de HBM4 (23,3 To/s de bande passante théorique) et annoncé à 20 Pflops en FP8 (sparse). Comme souvent avec ces puces, AMD n’a pas officialisé de TDP (à titre indicatif Vera Rubin avoisine les 2000 W).
De l’autre, le MI430X, pourvu de la même quantité de DRAM, mais positionné sur la convergence IA/HPC, avec une performance théorique de 288 Tflops en FP64. Disponibilité prévue pour 2027, avec en ligne de mire les AI (giga)factories. Le supercalculateur Alice Recoque en embarquera.
Helios AI ou la promesse de racks exaflopiques pour l’inférence FP8
Les EPYC Venice et les Instinct MI455X sont – avec les DPU/NIC Pensando – la matière première des racks Helios AI. Au menu, jusqu’à 72 GPU, 18 CPU et 31 To de mémoire HBM4 (1,7 Po/s). Puissance maximale théorique : 1,4 Eflops en FP8 (format numérique souvent utilisé en production pour l’inférence).
Les racks Helios AI utilisent le nouveau standard ORW (Open Rack Wide) de l’Open Compute Project. Les livraisons doivent démarrer ce trimestre. Bull, HPE, Lenovo et Supermicro, entre autres, fourniront des systèmes.
Ryzen AI Embedded : des P100 aux X100, un TDP doublé
Pour la robotique et plus globalement l’IA « physique », AMD dégaine les cartes Kria AI. Elles reposent sur la dernière génération des processeurs Ryzen AI Embedded (X100).
Ces derniers associent CPU (8 à 16 cœurs Zen 5), iGPU (32 ou 40 unités de calcul) et NPU (50 TOPS), pour un TDP de 55 W (contre 28 W pour la quasi-totalité des P100). Capacité maximale de la mémoire unifiée : 128 Go (273 Go/s en LPDDR5X-8533 sur bus 256 bits).
La production de masse des cartes Kria AI est attendue au T4 2026. Avec, comme partenaires, Arbor, Congatec, iBase, IEI, Sapphire et Seavo.
AMD prévoit une solution commune avec Cerebras pour cette année
À la même échéance, OpenAI entend mettre en service des racks Helios AI. Ce sera la première phase du déploiement de 6 GW annoncé en octobre 2025.
Aux dernières nouvelles, Meta a commencé à tester ces mêmes racks et à valider les EPYC Venice.
AMD travaille aussi avec Cerebras. Il s’engage à unifier ses puces avec les racks Helios AI en un « système d’inférence désagrégé ». Une solution commune devrait sortir d’ici à fin 2026, initialement au sein de l’offre Cerebras Cloud.
AMD a fixé le rendez-vous à l’occasion de sa conférence Advancing AI. La promesse : de la programmation GPU assistée par IA. Avec, comme principaux leviers, des skills et un système appelé Hyperloom.
AMD met à contribution son serveur Lemonade
Six skills sont pour le moment disponibles. On les retrouve dans les catalogues de plug-in de Claude et de Codex, ainsi que sur la marketplace Cursor.
Deux de ces skills ciblent l’exécution côté client, sur les puces Ryzen AI : Local AI Use et Local AI App Integration.
Local AI Use fait passer la génération d’images ainsi que la synthèse et la reconnaissance vocales par un serveur Lemonade local. Les agents sont invités à l’exploiter, entre autres, lorsque l’utilisateur déclare vouloir économiser des tokens ; ou s’il mentionne des éléments comme OmniRouter, SD-Turbo ou l’inférence NPU.
Local AI App Integration ajoute un mode local aux applications qui utilisent des API cloud, grâce à une version embarquée du serveur Lemonade. Les agents sont censés l’exploiter lorsque l’utilisateur évoque l’IA locale, hors ligne, privée, etc.
Les quatre autres skills ciblent l’exécution côté serveur. Deux d’entre elles créent un endpoint vLLM, respectivement sur les GPU Instinct et sur les CPU EPYC. AMD précise aux agents que la skill Instinct… ne doit pas être utilisée avec les GPU NVIDIA.
Les deux skills restantes sont connectées à Magpie (framework d’évaluation de noyaux GPU) et TraceLens (bibliothèque Python pour l’analyse de workflows d’inférence et d’entraînement).
5 autres skills dans les cartons
Quatre skillscross-stack sont en roadmap :
ROCm Doctor
Diagnostic des échecs ROCm, PyTorch et llama.cpp sur les GPU AMD à partir d’une liste de mauvaises configurations
Hyperloom Kernel Optimizer
Optimisation automatique de l’inférence sur les GPU AMD
vLLM Semantic Router
Paramétrage d’un routeur de requêtes
HRR Replay Analysis
Enregistrement, rejeu et analyse des workloads GPU entre accélérateurs Instinct, Radeon et Ryzen
AMD en prépare aussi une sur la partie client : APU Memory Tuner, avec laquelle les agents IA pourront régler la répartition entre mémoire dédiée et mémoire partagée.
Claude Code intégré au cœur du réacteur Hyperloom
On l’aura constaté : plusieurs de ces skills permettent d’exploiter le fameux Hyperloom. Ce système agentique a, sur le papier, un rôle : optimiser les workloads IA pour les GPU AMD (en l’état, MI300X, MI325X et MI355X). Il gère actuellement deux serveurs (SGLang, vLLM) et trois langages (HIP, Triton, FlyDSL).
Au bas de l’édifice se trouve TraceLens. La bibliothèque – agrémentée pour le coup d’une couche agentique – consomme les traces collectées par Magpie, qui s’appuie lui-même sur Intellikit (suite d’outils de profilage à bas niveau).
Cette analyse nourrit la boucle d’optimisation. La brique GEAK (Generating Efficient AI-Centric Kernels) en est le point central, chargée de générer les implémentations. À l’origine, elle optimisait noyau par noyau (« couche kernel ») La dernière version conserve cette option, mais peut aussi optimiser un workload dans son ensemble (« couche système »). Plusieurs modifications architecturales le permettent. En particulier, le remplacement de mini-swe-agent par Claude Code et ses workflows dynamiques. Mais aussi la réutilisation récursive de la couche kernel par la couche système (AMD parle de « conception fractale »). Et l’introduction d’Arbor. Cette méthode favorise l’exploration de l’espace d’optimisation en apportant un système de recherche arborescente qui fait office de mémoire de travail partagée.
Au-delà d’utiliser Claude Code dans le cadre d’Hyperloom, AMD l’exploite pour accélérer le développement de ROCm. Il travaille aussi avec OpenAI autour de Codex, qui « aide déjà à écrire du code Triton » et « progresse » avec Gluon.
AMD présente un mini PC capable d’exécuter des modèles d’IA gigantesques directement en local. Son atout ? Plus besoin de cloud, ni d’abonnement mensuel pour certains usages. À la clé, des économies qui peuvent vite devenir intéressantes. Intéressant, n’est-ce pas ?
Les utilisateurs le savent bien : profiter d’une IA puissante a un coût. Et parfois, les factures s’allongent chaque mois. Pourtant, AMD tente de montrer qu’une autre voie est possible. Lors d’une démonstration, le constructeur a mis en avant un mini PC équipé de sa puce Ryzen AI Max+ 395. Celui-ci est capable de faire tourner d’impressionnants modèles d’IA directement sur la machine. L’idée pourrait convaincre les professionnels soucieux de confidentialité, mais aussi les passionnés qui rêvent d’un assistant local, sans dépendre du cloud.
Ce que peut faire ce mini PC d’AMD
Au cœur de cette démonstration se trouve le processeur Ryzen AI Max+ 395, connu sous le nom de code Strix Halo. Installé dans des machines comme le GMKtec EVO-X2, il profite d’une mémoire unifiée pouvant atteindre 128 Go.
C’est ici que l’approche d’AMD prend tout son sens. Car une partie de cette mémoire peut être allouée au processeur graphique, offrant jusqu’à 96 Go de VRAM. Résultat, la machine peut charger des modèles d’IA bien plus volumineux que ce qu’autorisent la plupart des cartes graphiques grand public.
AMD acaba de dar un golpe fuerte en la IA local.
Lisa Su subió al escenario con un mini PC del tamaño de un libro grueso en una sola mano y ejecutó en vivo un modelo de 235 mil millones de parámetros. Sin datacenter. Sin cloud. Sin alquilar GPUs.
AMD affirme ainsi qu’il est possible d’exécuter des modèles atteignant 235 milliardsde paramètres en local sur son mini PC. Le tout via des outils gratuits comme Ollama. L’utilisateur conserve alors ses données sur sa propre machine. Pas d’envoi vers un serveur distant, ni de limite quotidienne imposée par un abonnement.
Sur certains tests présentés par le constructeur, cette configuration dépasserait même une RTX 5080 dans certaines tâches liées à l’inférence IA. Une affirmation qui reste toutefois dépendante des scénarios utilisés.
Une solution prometteuse, mais pas sans compromis
Pour les entreprises qui manipulent des données sensibles, faire tourner une IA directement en local représente un avantage évident. Les documents restent sur place et les coûts liés aux services cloud peuvent fortement diminuer.
Le témoignage d’un consultant spécialisé va d’ailleurs dans ce sens. Il explique avoir remplacé ses coûteuses locations de GPU par ce type de configuration. Selon lui, cela a amélioré la rentabilité de son activité. Un retour d’expérience intéressant, mais qui reste individuel et ne constitue pas une garantie universelle.
Tout n’est cependant pas parfait. Les performances varient selon les modèles utilisés. Face à des cartes très haut de gamme comme la RTX 5090, certaines IA s’exécutent encore plus lentement. Le logiciel ROCm, l’écosystème d’AMD pour l’IA, continue également de rattraper son retard sur CUDA, la plateforme de Nvidia. Même si la compatibilité progresse rapidement.
Certes, ce mini PC d’AMD ne remplacera pas tous les serveurs d’IA du jour au lendemain. En revanche, il montre qu’une exécution locale de modèles géants devient de plus en plus crédible sur des machines compactes.
C’est le grand retour des CPU et de la mémoire à l’ère de l’IA agentique.
Après l’euphorie autour de l’IA générative et l’explosion de la demande de GPU, les CPU et les mémoires reprennent de la valeur en Bourse comme dans les comptes d’exploitation.
Intel, AMD et Micron profitent d’un même mouvement de fond : la montée en puissance de l’IA agentique, des data centers et de la demande en capacités de calcul plus équilibrées.
Le marché croyait les processeurs classiques relégués derrière les GPU, indispensables à l’entraînement des modèles d’IA. Mais la montée des agents d’IA change la donne. Il faut désormais orchestrer davantage de tâches, de flux et d’inférences, ce qui redonne de l’importance aux CPU dans les datacenters.
Intel résume ce virage en affirmant que le ratio entre CPU et GPU dans certains usages est passé de 1 pour 8 à 1 pour 4, avec un mouvement qui pourrait encore favoriser les processeurs. AMD partage cette lecture et a relevé sa prévision de croissance du marché des CPU à 35 % par an en moyenne d’ici à 2030.
Ce rebond repose surtout sur les datacenters, où les CPU utilisés pour l’IA prennent le relais d’une activité PC plus molle.
Intel a aussi relevé ses prix, réorienté sa production vers les Xeon et tenté de reprendre la main sur le plan industriel avec sa nouvelle gravure 18A. En revanche, son bilan financier reste fragile avec des marges qui remontent lentement et une activité historique du PC qui demeure peu dynamique.
Les CPU reviennent au centre du jeu
AMD profite lui aussi du retournement, mais avec une dynamique plus lisible sur les ventes que sur la seule cote boursière. Au premier trimestre 2026, le groupe a annoncé 10,3 milliards $ de chiffre d’affaires, en hausse de 38 % sur un an, dont 5,8 milliards $ pour les puces serveurs Epyc et les GPU Instinct, soit une progression de 57 % sur un an.
Cette activité data center représente désormais 56 % des revenus d’AMD, ce qui montre sa dépendance à l’IA pour sa croissance.
Micron n’est pas un fabricant de processeurs au sens strict, mais sa trajectoire est liée au même cycle. Les mémoires sont devenues un goulot d’étranglement de l’IA, et le marché récompense les fournisseurs capables d’accompagner l’explosion des serveurs et des accélérateurs.
En 2025, Micron a été l’un des plus gros gagnants du secteur technologique en Bourse, porté par la demande en puces mémoire complémentaires des GPU utilisés dans l’IA. Autrement dit, le rebond concerne l’ensemble de l’écosystème qui permet de les alimenter en bande passante et en stockage rapide.
Ce mouvement n’efface pas les fragilités. Intel reste l’acteur le plus exposé à l’exécution de sa feuille de route, AMD doit transformer sa bonne dynamique commerciale en gains de parts de marché durables, et Micron reste très cyclique malgré la demande liée à l’IA.
Mais pour l’instant, les marchés ont tranché : les processeurs et la mémoire ne sont plus des segments « secondaires ». Ils redeviennent des actifs stratégiques, soutenus par une nouvelle phase de l’IA où la capacité à orchestrer les calculs compte autant que la puissance de calcul elle-même.

 Connexion