
❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

Qualcomm contre ARM, reprise du procès titanesque qui pourrait ébranler tout le monde de la tech
Le feuilleton judiciaire entre Qualcomm et ARM est reparti pour un tour. Un nouveau procès s’est ouvert le 5 octobre 2026 à Wilmington, dans le Delaware, devant la juge fédérale Maryellen Noreika. Les débats sont prévus sur cinq jours. Mais cette fois, les rôles sont inversés. Après avoir passé fin 2024 sur le banc des accusés dans l’affaire Nuvia, c’est Qualcomm qui attaque, sur la base d’un recours déposé en avril 2024.

Des outils retenus et une fuite qui aurait coûté cher

Le fabricant de puces reproche deux choses à ARM. D’abord, d’avoir retenu des outils de test de puces qui lui étaient dus en vertu du contrat liant les deux entreprises. Ensuite, d’avoir organisé en 2024 la fuite dans la presse d’une lettre menaçant de résilier sa licence d’architecture. Selon Qualcomm, cette divulgation a fait fondre d’environ 170 millions de dollars la valeur d’un accord potentiel avec Meta.

Mais l’enjeu financier réel du procès est ailleurs. Qualcomm estime que ces manquements l’autorisent, contractuellement, à suspendre le versement de ses redevances à ARM pendant cinq ans. Une somme qui pourrait atteindre plusieurs milliards de dollars. « Le retard coûte cher », a résumé Karen Dunn, l’avocate de Qualcomm, à l’ouverture des débats.

Rien n’est acquis pour autant. La juge Noreika examine si cette clause de suspension est juridiquement applicable. Si elle ne l’est pas, Qualcomm devrait se contenter de dommages et intérêts nettement plus modestes.
ARM conteste le moindre préjudice

Sans surprise, ARM rejette totalement la lecture de son adversaire. Sur le dossier Meta, le concepteur de puces attribue la révision des conditions commerciales à un virage stratégique du groupe de Mark Zuckerberg, qui a privilégié les lunettes connectées dopées à l’IA au détriment des casques de réalité virtuelle. Les pertes avancées par Qualcomm relèveraient donc de la pure spéculation. « Ils n’ont subi aucun préjudice, pas le moindre », a martelé Gregg LoCascio, qui défend ARM.

L’entreprise britannique renvoie aussi la balle sur le terrain de la confidentialité. Elle accuse Qualcomm d’hypocrisie, affirmant que le groupe de San Diego a lui-même laissé filtrer des informations non publiques sur des enquêtes antitrust la visant.

Une hausse de 1 800 % en toile de fond

En parallèle du procès devant jury, un second volet, jugé par la cour seule, se penche sur la question de savoir si ARM a négocié de bonne foi avec Qualcomm l’accès à la prochaine version de sa technologie. Qualcomm affirme qu’ARM lui a réclamé une augmentation de 1 800 % de ses redevances entre la version 9 et la version 10 de son architecture. Signalons qu’un accord signé en 2013 plafonnait ces redevances à 1,88 dollar par puce dès lors que celle-ci embarque au moins cinq cœurs de processeur. Un seuil dérisoire aujourd’hui, certaines puces pour centres de données alignant désormais 288 cœurs. Cristiano Amon, le PDG de Qualcomm, est venu témoigner sur ce volet dès la première journée, balayant les arguments adverses d’un « je ne vois pas les choses ainsi ».

Ce nouveau procès s’inscrit dans un contentieux au long cours. Après le rachat de Nuvia par Qualcomm en 2021 pour environ 1,4 milliard de dollars, ARM avait résilié la licence de la jeune pousse dès 2022 et exigé la destruction des technologies développées sous ce contrat. En décembre 2024, un jury avait estimé qu’ARM n’avait pas démontré de violation de la licence de Nuvia, et que les processeurs issus de cette acquisition étaient couverts par la propre licence d’architecture de Qualcomm. La juge Noreika a rendu un jugement définitif en faveur de Nuvia en septembre 2025, rejetant les dernières demandes d’ARM, qui a fait appel devant la Cour d’appel du troisième circuit. Quelle que soit l’issue des débats de Wilmington, les deux entreprises resteront liées un bon moment, leur accord de licence d’architecture courant jusqu’en 2033.
Révolution en vue pour le gaming mobile avec le DLSS bientôt sur Android ?

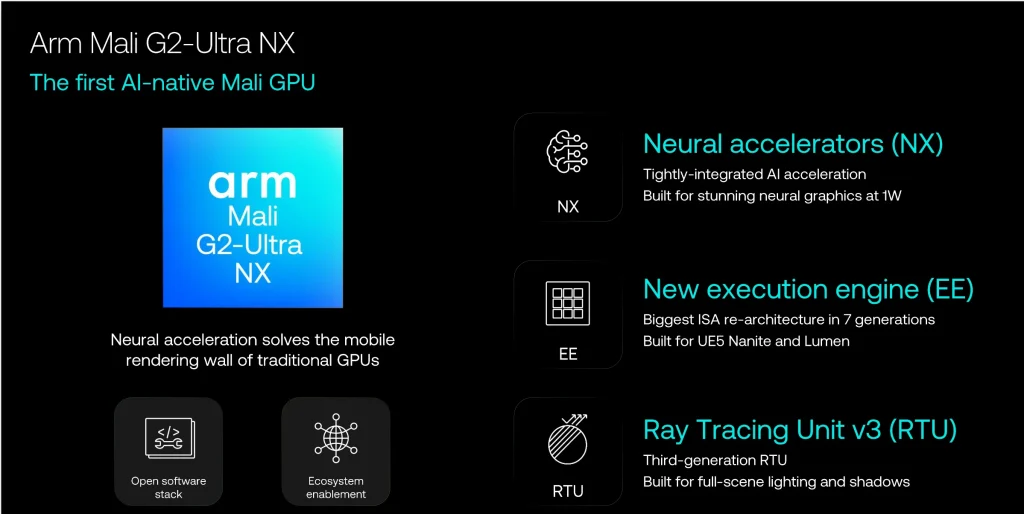
ARM vient de lever le voile sur le Mali G2-Ultra NX, présenté comme son premier GPU nativement conçu pour l’IA. La nouvelle plateforme du concepteur britannique embarque également des cœurs CPU inédits, baptisés C2. Et le moins que l’on puisse dire, c’est qu’ARM ne fait pas dans la demi-mesure, puisque la firme parle du plus gros bouleversement apporté à la famille Mali en sept générations.

La promesse tient en une idée simple : plutôt que de déporter les calculs d’IA vers un NPU distant, le G2-Ultra NX intègre un accélérateur neural, le fameux NX, directement au sein du cœur shader du GPU. De quoi, en théorie, transformer la manière dont les jeux mobiles sont rendus à l’écran sur nos smartphones et nos tablettes.

Un accélérateur neural au plus près des pixels

Ce bloc NX prend en charge les opérations INT8 et INT16 et dispose de son propre module de traitement du mouvement. Détail intéressant, il peut grimper jusqu’au double de la fréquence d’horloge du GPU principal, tout en conservant la même tension. Sa consommation, elle, peut descendre à 1 W en fonctionnement.

Pour illustrer l’intérêt de la chose, ARM a co-développé avec le studio Sumo Digital une démonstration nommée Neural Dawn. Sans l’accélérateur, la scène plafonne à 15 images par seconde, autant dire injouable. Avec le NX activé, elle tourne à 60 fps soutenus pour un budget énergétique d’à peine plus de 2 W. ARM en tire deux chiffres chocs, une efficacité quadruplée et jusqu’à 70 % de trafic mémoire externe en moins par rapport à un rendu conventionnel. Des valeurs annoncées par le constructeur sur sa propre démo, qu’il faudra évidemment confronter à des jeux réels.

Upscaling et interpolation d’images, le duo gagnant

Concrètement, cet accélérateur alimente plusieurs technologies neurales. Le Neural Super Sampling (NSS) fait passer l’image de 540p à 1080p en n’exploitant qu’un quart des données d’entrée traditionnelles. Le Neural Frame Rate Upscaling (NRFU), lui, double le taux de rafraîchissement, de 30 à 60 fps par exemple, en s’appuyant sur la profondeur et les vecteurs de mouvement de deux paires d’images. L’estimation du flux optique est accélérée matériellement, grâce à un moteur de mouvement intégré à l’architecture G2 qui fonctionne sur le même principe que les moteurs d’encodage vidéo.

Chris Bergey, vice-président exécutif de la division Edge AI d’ARM, résume l’ambition. « Si nous pouvons offrir une expérience remarquable en 540p à 30 images par seconde, et que cela permet d’utiliser une batterie plus petite, alors cela autorise un format plus compact et, potentiellement, une console portable moins chère. »

Notez que ces modèles neuraux exigent un GPU doté des capacités NX. Le Mali G1 de la génération précédente, celui qui équipe notamment le MediaTek Dimensity 9500 dans sa déclinaison G1-Ultra, n’y aura donc pas droit. NSS est disponible depuis l’an dernier et NRFU vient tout juste d’être publié, les deux étant accessibles aux développeurs sur Hugging Face. ARM mise par ailleurs sur Vulkan ML et autorise les studios à entraîner et distribuer leurs propres modèles avec leurs jeux.

Une gamme à géométrie variable et des gains bien réels

La série G2 se décline en cinq configurations, à savoir G2-Ultra NX, G2-Premium NX, G2-Premium, G2-Pro NX et G2-Pro. Le haut de gamme Ultra propose de 10 à 24 cœurs shader, avec au moins un cœur NX obligatoire pour arborer le label. Le segment Premium vise le milieu de gamme mobile avec six à neuf cœurs, tandis que le Pro se contente de cinq cœurs au maximum, l’accélération IA y restant optionnelle.

Même sans IA, l’architecture progresse. Le nombre de registres par warp double, passant de 64 à 128, avec 16 paliers d’allocation dynamique. L’unité de ray tracing de troisième génération réduit le trafic DRAM de 13 % et prend en charge, une première pour la série, les opacity micromaps accélérées matériellement. Résultat, jusqu’à 24 % de mieux en ray tracing par rapport au G1-Ultra selon le design de référence.

En jeu, ARM mesure des gains de 9 % sur Honkai Star Rail et de 14 % sur Fortnite face à une plateforme G1-Ultra à 14 cœurs, la comparaison intégrant toutefois un écart de fréquence, 1,70 GHz contre 1,53 GHz. Sur les benchmarks graphiques les plus exigeants, la firme table sur des progressions pouvant atteindre 24 %.

Des cœurs C2 taillés pour les agents IA

Le GPU ne voyage pas seul. Les nouveaux cœurs CPU C2 revendiquent jusqu’à 15 % de performances supplémentaires en mono-thread et 12 % en multi-thread par rapport aux C1. Sur les modèles d’IA, ARM annonce des performances multipliées par 1,7 pour une consommation réduite de 38 %. Les C2-Ultra boucleraient même un workflow agentique type 24 % plus vite que la génération précédente, sans que la nature exacte de ce scénario de référence soit détaillée.

Reste la question du calendrier. ARM n’a communiqué ni partenaires, ni puces, ni appareils pour ce CSS for Mobile 2. Il existe cependant un premier jalon concret puisque la démo Neural Super Sampling and Denoising (NSSD), actuellement en accès anticipé, sera jouable en 2026.

Le datacenter IA, trame idéale pour le premier CPU d’Arm

Dans les datacenters IA, les CPU ont toute leur place pour orchestrer la mécanique. Et le besoin va s’accentuer avec l’agentique.

Il y a quelques semaines, Arm a contextualisé ainsi le lancement de son premier processeur, pour serveurs. Nommé AGI CPU, il est basé sur l’architecture Neoverse V3. Comme, entre autres, les puces Vera (NVIDIA), Graviton (AWS), Cobalt (Microsoft) et Axion (Google).

Arm propose des configurations à 64, 128 et 136 cœurs, dans une enveloppe thermique de 300 W. Il a conçu un serveur de référence (1U, à 1 ou 2 nœuds), décliné en un rack avec refroidissement à air (30U, 36 kW, jusqu’à 8160 cœurs). ASRock et Lenovo en ont aussi à leur catalogue. Comme Supermicro, avec lequel Arm a également conçu un design 42U à refroidissement liquide (200 kW ; jusqu’à 45 696 cœurs).

serveur de référence Arm

Côté mémoire, la DDR a été préférée à la LPDDR, tant pour des questions de coût que de capacité. Vu les limites de bande passante (6 Go par cœur dans la config à 136 cœurs), Arm n’a pas jugé idéal d’intégrer le multithreading – d’autant plus que l’amélioration du rapport performance par watt n’est pas significative. Pour l’I/O, on est sur du PCIe Gen6 (+ CXL 3), en attendant la prise en charge de NVLink dans une future révision de Neoverse.

SAP intéressé pour HANA

rack AGI GPULes datacenters en sont arrivés à une densité d’environ 30 millions de cœurs CPU par GW, affirme Arm. L’entreprise estime que pour absorber les workloads agentiques, il en faudrait 4 fois plus. Et pour cause : ces workloads sont asynchrones, ce qui engendre autant de travail de planification et de contrôle des flux. Des tâches qu’on peut déléguer à des CPU, en concentrant les GPU sur la production des tokens.

L’opérateur coréen SK Telecom fait partie des clients de l’AGI CPU. Il l’exploite comme nœud de tête, en combinaison avec des NPU de Rebellions, pour faire tourner son modèle de fondation A.X.
Arm a aussi rallié Cloudflare et F5 Networks. Ainsi que SAP. Le groupe allemand a déployé HANA sur Graviton chez AWS et cherche à en reproduire les capacités sur d’autres environnements, notamment dans le contexte des offres « souveraines ».

La première demande était toutefois venue de Meta, qui compte utiliser l’AGI CPU en association avec ses accélérateurs MTIA. Il a déjà travaillé avec Arm pour adapter diverses briques logicielles, dont PyTorch, vLLM et FBGEMM (Facebook GEneral Matrix Multiplication). Objectif, dans les grandes lignes : tous les watts économisés sur le CPU alimenteront l’inférence.

AGI CPU

Les néoclouds dans le viseur

Ce SoC est une première pour Arm. Qui, jusqu’ici, vendait de l’IP (blocs de propriété intellectuelle) et du CSS (sous-systèmes packageant ces blocs). En livrant des puces, il se donne la possibilité de toucher des acteurs qui n’ont pas les moyens ou l’échelle pour développer les leurs, en tout cas en temps voulu : telcos, néoclouds, fournisseurs réseau…

Quant à la perspective de concurrencer ses clients actuels, Arm assure ne pas être inquiet : le marché est suffisamment grand. Il rappelle avoir connu, avec le CSS, une situation similaire qui n’a, au final, pas compromis ses relations contractuelles. Son patron Rene Haas avance aussi, à demi-mot, l’argument de la neutralité… que n’auront peut-être pas les « clients-concurrents » (il évoque les CPU Vera, conçus pour fonctionner avec le GPU Rubin, avec une interface spécifique et un nombre de cœurs optimisé).

Arm a des clients engagés pour les deux premières générations de son CPU (2026-2027). Il dit avoir en ligne de mire « plus d’un milliard de dollars de revenus » sur un horizon de 2 ans. La capacité a été sécurisée auprès de TSMC via un partenaire ASIC. La pénurie de mémoire inquiète davantage Rene Haas.

Sur l’IP, Arm annonce un taux de royalties de 5 %, pour autant de marge brute. C’est 10 % sur le CSS. Ses puces, clame-t-il, lui permettront de dégager 50 % de marge brute. Elles feront probablement l’objet d’un segment distinct dans le reporting financier.

Illustrations © Arm

The post Le datacenter IA, trame idéale pour le premier CPU d’Arm appeared first on Silicon.fr.

IBM veut capter les workloads Arm sur ses mainframes

Une « collaboration stratégique » de plus pour IBM, et cette fois, c’est avec Arm.

Principal axe en l’état : la virtualisation des logiciels Arm sur les mainframes. Big Blue ne manque pas la référence aux « workloads modernes », « IA et data-intensive »… Il se projette, à plus long terme, sur des « couches technologiques partagées » entre les deux écosystèmes.

Quelques heures avant cette annonce, ses équipes avaient ajouté un patchset dans le noyau Linux. Il active la virtualisation Arm64 sur s390 en introduisant une couche KVM commune.
Pour le moment, l’instruction SAE (Start Arm Execution) est introduite comme mécanisme d’exécution des invités. De futurs patchs ajouteront, « dans les prochains mois », la gestion des registres système, des interruptions, des PMU, etc.

Apporter les garanties de fiabilité des mainframes à cet écosystème – tout en rapprochant les applications des données – pourrait dissuader les clients de se tourner vers des serveurs Arm spécifiques. A fortiori dans le contexte économique actuel des composants électroniques.

Côté x86, IBM a déjà dans son portefeuille la couche d’émulation PowerVM Lx86. Ce traducteur binaire permet d’exécuter les applications Linux sur quelques gammes de serveurs dont les System p.

À consulter en complément :

Claude Code, la fin des mainframes ? IBM crie à l’amalgame
Dans le cloud public, le rapport coût-performance stagne
AWS rejoint Azure et Google Cloud sur la virtualisation imbriquée
Du couac Fluidstack à la levée de dette, Mistral AI face aux aléas de l’infra

Illustration générée par IA

The post IBM veut capter les workloads Arm sur ses mainframes appeared first on Silicon.fr.

❌