Des chercheurs de l’Université de Hong Kong ont mis au point une puce neuromorphique capable de fonctionner à une température proche du zéro absolu. En imitant l’activité électrique des neurones, elle pourrait piloter de façon fiable et sécurisée des dizaines de milliers de qubits en utilisant...
En laissant un algorithme explorer des géométries qu’aucun ingénieur n’aurait spontanément conçues, des chercheurs de Harvard et de l’Institut Max-Planck ont miniaturisé à l'extrême plusieurs composants essentiels des puces photoniques.
Samsung a dévoilé la puce V10 BV-NAND, capable d’empiler plus de 400 couches de mémoire flash. Son objectif ? Répondre aux besoins des futurs systèmes et applications d'intelligence artificielle.
Des chercheurs ont développé un processeur quantique à base de silicium pouvant prendre en charge des opérations de calcul quantique et exécuter de manière autonome la correction d’erreurs. Ce type de système permettrait de résoudre le problème de contrôle du grand nombre de qubits nécessaire au calcul quantique sans les systèmes de câblage complexes soutenant […]
D’après les dernières nouvelles, Anthropic avance sur une puce IA personnalisée et discute avec Samsung pour sa fabrication. Un projet encore exploratoire, mais qui pourrait peser sur le coût, la latence et l’efficacité énergétique de Claude pour les entreprises.
Anthropic veut reprendre davantage de contrôle sur l’infrastructure qui fait tourner Claude. Selon The Information, l’entreprise échange avec Samsung autour d’une puce IA sur mesure. Les caractéristiques du composant restent à définir. Mais derrière ce chantier encore exploratoire, un enjeu concerne directement les entreprises. Celui de mieux maîtriser le matériel qui exécute les modèles d’IA et de réduire leur coût d’utilisation.
Anthropic et Samsung explorent une puce IA optimisée pour Claude
Le projet reste à un stade où de nombreuses décisions techniques ne sont pas arrêtées. Anthropic n’aurait pas encore défini l’usage de la puce, son intégration aux serveurs ni le niveau de puissance recherché. Il serait donc prématuré d’y voir un futur accélérateur aux performances déjà établies.
Jusqu’ici, les développeurs de grands modèles s’appuient sur des accélérateurs conçus pour servir de nombreux usages. Une puce pensée en fonction des besoins de Claude pourrait permettre à Anthropic d’optimiser plus étroitement le modèle, les serveurs et le matériel chargé des calculs.
Pour les utilisateurs professionnels, les conséquences potentielles sont concrètes. Une meilleure efficacité du traitement pourrait contribuer à réduire le coût d’inférence. La latence et la consommation énergétique figurent également parmi les paramètres qu’une architecture personnalisée pourrait chercher à améliorer.
Ces gains restent des objectifs possibles, et non des performances confirmées. Anthropic souligne d’ailleurs qu’une infrastructure diversifiée demeure au cœur de sa stratégie informatique. Celle-ci qui repose notamment sur des puces de Google, Amazon et Nvidia. Une puce développée avec Samsung viendrait donc probablement compléter cet environnement. Plutôt que de le remplacer immédiatement.
Anthropic is reportedly in early talks with Samsung to manufacture a custom AI chip for Claude infrastructure.
Samsung is being considered for its 2nm process and advanced packaging as Anthropic explores how the chip would fit into future AI servers and clusters. pic.twitter.com/cTcz2bsJvs
Une puce Claude pourrait changer le coût de l’IA pour les entreprises
Le coût d’exploitation des modèles devient un sujet central car les entreprises déploient de plus en plus l’IA à grande échelle. Quelques assistants internes génèrent une charge limitée. Des milliers d’agents ou d’applications qui utilisent Claude en continu changent donc l’équation financière.
Pour Anthropic, travailler avec Samsung pourrait aussi réduire sa dépendance à Nvidia, leader du marché des puces IA. Le groupe sud-coréen possède déjà une expérience importante dans ce secteur. Et il collabore étroitement avec Nvidia sur la fabrication de composants destinés à l’entraînement et à l’exécution des modèles.
Alors, si Anthropic parvient à adapter plus finement son infrastructure aux besoins de Claude, l’entreprise pourrait mieux contrôler les coûts, l’efficacité énergétique et les capacités de déploiement de ses modèles. Pour les clients B2B, ces optimisations pourraient à terme se traduire par une IA plus facile à industrialiser. Mais tant que l’architecture et les fonctions de la puce ne sont pas définies publiquement, son impact réel reste encore à démontrer.
La startup américaine Etched a levé 500 millions de dollars lors d’un tour de table qui porte sa valorisation à 5 milliards de dollars. Elle affirme aussi avoir déjà enregistré un milliard de dollars de commandes pour ses premiers systèmes d’inférence IA. Cette progression rapide témoigne de l’appétit du marché pour des alternatives aux GPU traditionnels de Nvidia.
Etched ambitionne de concurrencer Nvidia sur le marché des accélérateurs IA. La startup américaine annonce avoir atteint une valorisation de 5 milliards de dollars après une nouvelle levée de fonds de 500 millions de dollars. Plus marquant encore, l’entreprise affirme avoir déjà sécurisé un milliard de dollars de commandes pour son premier produit. Alors même que celui-ci est encore en phase de test auprès de ses premiers clients. Les investisseurs s’intéressent de plus en plus aux technologies capables de réduire le coût de l’inférence. Car celle-ci est désormais considérée comme l’un des principaux défis économiques de l’IA générative.
Comment Etched veut concurrencer Nvidia sur les puces IA ?
Fondée en 2022 par Gavin Uberti et Robert Wachen, deux anciens étudiants de Harvard devenus boursiers Thiel, Etched défend une approche différente de celle des GPU polyvalents qui dominent aujourd’hui le marché. La startup développe des puces spécialisées exclusivement destinées à l’inférence. C’est-à-dire l’étape où un modèle d’IA traite les requêtes des utilisateurs pour générer une réponse.
Ce segment est devenu très important. Car les entreprises déploient des modèles d’IA à grande échelle. L’inférence représente la plus grande partie des coûts d’exploitation et est souvent le principal goulot d’étranglement en matière de performances. Ainsi, toute innovation qui permet de réduire les dépenses énergétiques attire naturellement l’attention des investisseurs comme des grands acteurs du cloud. Et aussi celle quipermet d’accélérer les temps de réponse et d’améliorer le rendement des infrastructures.
Après la fabrication réussie de sa première puce par TSMC en début d’année, Etched commercialise désormais des systèmes complets. La startup le qualifie de « clusters d’inférence de pointe ». L’offre associeles puces, les racks et une couche logicielle pour optimiser les performances. Selon l’entreprise, cela permet d’obtenir une inférence plus rapide, moins coûteuse et plus efficace sur le plan énergétique que les solutions concurrentes.
Etched is another piece of evidence of that you can just do things. Two college dropouts going from nothing to taping out a chip in 3 years.
In the summer of 2023, @bfspector & I signed the first-ever order form for an Etched chip. We asked to put in a contractual guarantee that… https://t.co/7Tx0U9QFZh
Plusieurs clients évaluent actuellement les premiers systèmes. Malgré cette phase de validation, la startup affirme déjà disposer d’un carnet de commandes atteignant un milliard de dollars. C’est un signal très fort pour une entreprise dont le premier produit n’est pas encore déployé à grande échelle.
Pourquoi la startup séduit les investisseurs avec une valorisation de 5 milliards de dollars ?
Avec cette nouvelle levée de fonds, Etched porte le montant total de ses financements à 800 millions de dollars. Le tour de table de 500 millions de dollars, finalisé en décembre mais dévoilé seulement aujourd’hui, valorise désormais la société à 5 milliards de dollars.
L’opération réunit plusieurs investisseurs institutionnels spécialisés dans la finance quantitative et la technologie. Parmi lesquels VentureTech Alliance, Jane Street, Hudson River Trading, Two Sigma, Ribbit Capital et Stripes, qui a piloté le financement. À cela s’ajoutent des investisseurs providentiels très influents dans l’écosystème de l’IA. Comme Andrej Karpathy, Geoffrey Hinton, Fei-Fei Li, Arthur Mensch ou encore Scott Wu, ainsi que les milliardaires Peter Thiel et Stanley Druckenmiller.
Cette réussite contraste beaucoup avec la situation d’Etched il y a seulement deux ans. En 2023, les fondateurs avaient expliqué avoir essuyé de nombreux refus d’investisseurs. Et cela, malgré une note de trente pages détaillant leur conviction que les modèles d’IA auraient rapidement besoin de puces spécialisées plutôt que de GPU généralistes. L’entreprise fonctionnait alors avec des ressources limitées, au bord de la faillite.
Mais, l’explosion de la demande pour l’IA générative pousse désormais les investisseurs à rechercher les prochaines architectures qui améliorent les performances et réduisent les coûts d’exploitation. Dans le même temps, les fabricants alternatifs se multiplient. Groq a récemment levé 650 millions de dollars. Tandis que les grands fournisseurs cloud comme Amazon, Google et Microsoft développent leurs propres accélérateurs IA. Même OpenAI s’est engagé dans cette voie avec sa première puce personnalisée conçue avec Broadcom.
Si Etched parvient donc à tenir ses promesses en matière de performances et de coûts, elle pourrait contribuer à diversifier le marché qui est aujourd’hui dominé par Nvidia. La startup pourrait aussi accélérer l’adoption de nouvelles architectures dédiées aux charges de travail d’IA les plus exigeantes.
Apple cherche une dérogation pour acheter des puces CXMT, malgré une alerte politique évidente.
Apple a rarement l’air pressé, sauf quand la RAM commence à coûter sérieusement cher. Après des hausses d’environ 20 % sur plusieurs Mac et iPad, Cupertino cherche une échappatoire. Selon The Verge, Apple voudrait acheter des puces mémoire chez le chinois CXMT. Le Financial Times évoque six sources proches d’un lobbying déjà lancé à Washington. Apple aurait d’abord contacté le Commerce, puis élargi ses discussions avec l’administration Trump. CXMT figure sur une liste noire du Pentagone pour des liens présumés avec l’armée chinoise. Cela ne rend pas l’achat impossible, mais transforme chaque commande en grenade politique.
Une dérogation possible mais inflammable
NEW: 🇺🇸🇨🇳 Apple is lobbying the Trump administration for approval to source memory chips from ChangXin Memory Technologies, a Chinese chipmaker on the Pentagon's blacklist over alleged ties to the Chinese military, according to FT. pic.twitter.com/8HuJ3LpyNm
Juridiquement, acheter chez CXMT n’est pas formellement interdit aux entreprises américaines. Mais Apple ne cherche pas seulement une facture moins salée auprès d’un fournisseur alternatif.
En fait, CXMT devait rejoindre l’Entity List du département du Commerce, l’étape vraiment toxique. La procédure a été suspendue pendant les négociations commerciales menées entre Washington et Pékin. Résultat, le fabricant reste dans un entre-deux pratique pour personne, sauf les avocats.
Le précédent YMTC flotte déjà dans l’air, et il n’a rien d’un souvenir chaleureux. En 2022, Apple avait envisagé ce fournisseur chinois avant un rappel brutal du Congrès. Des élus avaient alors prévenu Cupertino des conséquences législatives d’un tel choix industriel.
Avec CXMT, les mêmes questions de sécurité nationale reviennent, emballées dans un autre carton. Une approbation de Trump déclencherait probablement une réaction musclée sur Capitol Hill. Autrement dit, Apple peut acheter moins cher, mais pas sans bruit politique.
La pénurie que personne ne veut payer seul
L’affaire devient plus piquante quand on regarde le marché mémoire des dernières années. Apple a longtemps utilisé son poids d’acheteur pour arracher des prix très bas. Chez Micron, un responsable commercial avait qualifié ces pratiques de « non constructives ».
Le reproche était simple, mais pas très flatteur pour la marque la plus rentable. En serrant trop les prix, les gros clients auraient découragé les investissements industriels. Des fabricants ont ralenti, reporté ou annulé des extensions de capacités. Puis l’IA est arrivée, avec son appétit de serveur affamé et ses marges dodues. La demande a explosé, et la pénurie prévisible est devenue une crise ouverte. Voilà comment un vieux bras de fer tarifaire revient frapper les MacBook au portefeuille.
Toutefois, CXMT ne fabrique pas la mémoire la plus stratégique du moment. Son catalogue vise surtout la DRAM classique, comme la DDR5 et la LPDDR5X. La HBM, mémoire reine des accélérateurs NVIDIA, reste hors de son terrain. Micron et ses concurrents garderaient donc leurs meilleures marges sur ce segment.
Pour Apple, l’intérêt serait plutôt de sécuriser des volumes moins chers. Tim Cook avait déjà résumé la ligne en appelant à « tout mettre sur la table ». La diversification fournisseurs reste cohérente, mais la politique américaine adore compliquer les équations simples. Cette fois, la relation de Cook avec Trump pourrait aider, ou aggraver l’affaire. Le Congrès, lui, risque surtout de rappeler que la RAM n’efface pas la géopolitique.
En partenariat avec Broadcom, OpenAI dévoile Jalapeño, sa première puce d’IA dédiée à l’inférence des grands modèles de langage. Développé en seulement neuf mois, ce processeur promet une efficacité énergétique supérieure aux accélérateurs actuels
OpenAI ne veut plus seulement concevoir les modèles d’IA les plus avancés du marché. L’entreprise entend désormais maîtriser le matériel qui les fait fonctionner. OpenAI a donc présenté, aux côtés de Broadcom, Jalapeño, son tout premier processeur d’intelligence artificielle dédié à l’inférence des grands modèles de langage (LLM). Les premiers tests annoncent des performances par watt supérieures aux solutions actuelles. Tandis que la puce a été développée en un temps record de neuf mois.
Pourquoi OpenAI et Broadcom lancent la puce Jalapeño ?
Les accélérateurs généralistes sont plutôt adaptés aux charges de travail de l’IA. Mais Jalapeño a été conçu dès l’origine pour répondre aux besoins spécifiques de l’inférence des LLM. L’objectif est d’améliorer simultanément les performances, la latence et l’efficacité énergétique des services qui exploitent des modèles comme ChatGPT, Codex ou les futurs agents d’OpenAI.
Cette approche repose sur une connaissance approfondie des contraintes propres aux modèles de langage. OpenAI a défini l’architecture de la puce en optimisant les échanges entre les unités de calcul, la mémoire et le réseau. C’est pour limiter les transferts de données, souvent responsables d’une partie importante de la consommation énergétique des infrastructures IA. Les premiers prototypes exécutent déjà des charges de travail proches des conditions de production. Notamment avec GPT-5.3-Codex-Spark.
We’ve designed and built our first AI chip: Jalapeño.
Designed from the ground up by OpenAI and brought to production with @Broadcom, Jalapeño is purpose-built for the LLM workloads powering ChatGPT, Codex, the API, and future agentic products.
Broadcom apporte de son côté son expertise dans la mise en œuvre sur silicium ainsi que ses technologies réseau, dont Tomahawk. Tandis que Celestica intervient sur les cartes électroniques, les racks et l’intégration des systèmes. Cette répartition des rôles permet à OpenAI de conserver la maîtrise de la conception. Et aussi à s’appuyer sur des partenaires industriels capables d’assurer une montée en puissance rapide.
Comment ce nouveau processeur IA optimise l’inférence des modèles de langage
Avec Jalapeño, OpenAI étend son contrôle à l’ensemble de la chaîne technologique. Depuis les puces jusqu’aux systèmes de déploiement. En passant par les logiciels d’exécution et les produits destinés aux utilisateurs.
Cette stratégie répond au enjeu de maîtrise du coût de l’inférence. Le calcul nécessaire pour répondre aux requêtes représente une part croissante des dépenses opérationnelles. Alors que les usages de l’IA générative continuent de progresser dans les entreprises. Une puce mieux adaptée permet non seulement de réduire la consommation électrique. Mais aussi d’augmenter le nombre de requêtes traitées pour une même infrastructure.
Selon OpenAI, les premiers essais montrent des performances par watt supérieures aux accélérateurs de référence actuels. Même si les résultats détaillés seront publiés ultérieurement. Si ces promesses se confirment, Jalapeño pourrait améliorer la rentabilité des services d’IA. Cette nouvelle puce pourra aussi offrir une meilleure qualité de service aux entreprises qui utilisent les API d’OpenAI ou ChatGPT.
Quels bénéfices attendre de Jalapeño pour les entreprises ?
Jalapeño est également le socle d’une plateforme de calcul appelée à évoluer sur plusieurs années. OpenAI et Broadcom prévoient un déploiement progressif dès la fin de 2026 auprès de partenaires qui exploitent des centres de données à l’échelle du gigawatt.
$AVGO and OpenAI unveiled Jalapeño which is OpenAI’s first custom AI chip built for LLM inference.
Broadcom says this is the start of a multi-generation roadmap for gigawatt-scale AI data centers with $MSFT and other partners beginning in 2026. pic.twitter.com/DuXeBMzBPO
L’un des aspects les plus marquants du projet est aussi sa rapidité d’exécution. Le développement complet de Jalapeño, de la conception à la fabrication, n’a nécessité que neuf mois. OpenAI explique que ses propres modèles d’IA ont participé à accélérer certaines phases de conception et d’optimisation matérielle. Ce qui illustre un cercle vertueux où l’IA contribue désormais à construire l’infrastructure nécessaire à son propre fonctionnement.
Pour le marché, cette annonce confirme qu’ après les géants du cloud et plusieurs hyperscalers, OpenAI rejoint les entreprises qui investissent dans des accélérateurs propriétaires. Afin de mieux contrôler leurs coûts, leurs performances et leur indépendance technologique. L’entreprise cherche à optimiser les charges d’inférence les plus critiques avec un matériel spécifiquement conçu pour ses besoins. Sans abandonner les GPU de fournisseurs comme Nvidia,
Je pense que cette stratégie pourrait avoir un impact bien au-delà de l’écosystème d’OpenAI. Des coûts de calcul plus faibles, une meilleure efficacité énergétique et des infrastructures plus performantes… Tout cela ouvrirait la voie à des services d’IA plus rapides, plus fiables et plus abordables. Que ce soit pour les développeurs, les PME comme les grandes entreprises. Cela renforcerait également la compétitivité d’OpenAI sur le marché.
Non, Sam Altman n’a pas dévoilé un nouveau modèle d’IA ni une nouvelle version de ChatGPT. Cette fois, OpenAI présente sa première puce IA, baptisée Jalapeño, avec l’ambition d’accélérer ses modèles et de mieux maîtriser toute son infrastructure.
Pendant des années, OpenAI s’est surtout illustrée par ses modèles d’intelligence artificielle. Elle dépendait également des GPU de Nvidia pour les entraîner et les exécuter. Maintenant, la société de Sam Altman veut reprendre la main sur le matériel qui les alimente. Avec Jalapeño, elle entre officiellement dans le cercle très fermé des acteurs qui conçoivent leurs propres puces.
Quelles sont les caractéristiques de la nouvelle puce IA d’OpenAI ?
Oubliez les processeurs généralistes adaptés à l’IA à coups d’optimisations. Jalapeño a été pensé dès le départ pour une mission précise. Celle de faire tourner les grands modèles de langage (LLM) avec davantage d’efficacité.
Concrètement, cette nouvelle puce d’inférence ne sert pas à entraîner les modèles, mais à produire leurs réponses. C’est cette étape qui intervient chaque fois qu’un utilisateur pose une question à ChatGPT ou sollicite un assistant basé sur un LLM.
We’ve designed and built our first AI chip: Jalapeño.
Designed from the ground up by OpenAI and brought to production with @Broadcom, Jalapeño is purpose-built for the LLM workloads powering ChatGPT, Codex, the API, and future agentic products.
Selon OpenAI, les premiers prototypes de cette puce IA atteignent déjà les fréquences et la consommation électrique prévues pour une utilisation en production. Les premiers essais montrent aussi une amélioration notable des performances par watt face aux accélérateurs actuels. Il faudra toutefois attendre la publication des benchmarks complets pour vérifier ces promesses.
Pour y parvenir, l’entreprise explique avoir réduit les transferts de données et mieux équilibré les ressources entre calcul, mémoire et réseau. L’idée paraît simple. Sa mise en œuvre, elle, demande des années d’ingénierie et quelques milliards de transistors.
OpenAI n’a toutefois pas mené ce projet en solitaire. Pour transformer cette ambition en réalité, l’entreprise s’est appuyée sur Broadcom, qui apporte son expertise dans la conception des semi-conducteurs. De son côté, Celestica prend en charge l’intégration des cartes, des racks et des systèmes destinés aux centres de données.
Ce n’est que le début !
OpenAI l’indique noir sur blanc sur son site. Sa première puce IA, Jalapeño, n’est que le commencement. Cette première génération doit servir de base à une plateforme matérielle appelée à évoluer au fil des prochaines années.
Les premiers déploiements à grande échelle sont attendus dès la fin de l’année 2026. Ils auront notamment lieu dans des centres de données développés avec plusieurs partenaires.
L’entreprise affirme avoir conçu l’ensemble du projet en seulement neuf mois. Un délai particulièrement court dans l’industrie des semi-conducteurs. Pour accélérer certaines étapes, ses propres modèles d’intelligence artificielle auraient participé à l’optimisation de la conception. L’IA aide donc désormais à fabriquer les puces qui feront fonctionner les prochaines IA. La boucle est presque bouclée.
Google franchit un cap technique majeur avec le lancement de la Google TPU v8. Cette nouvelle puce est prévue pour dominer le marché de l’IA. Cette huitième génération se divise en deux versions distinctes, la v8t et la v8i. L’objectif de la firme est de répondre aux exigences spécifiques de l’entraînement et de l’inférence. La firme veut à tout prix imposer son rythme face aux solutions de NVIDIA.
L’annonce de la Google TPU v8 le 22 avril 2026 marque l’entrée officielle dans ce que Google nomme l’ère agentique. Cela arrive au moment où les modèles ne se contentent plus de discuter mais agissent concrètement. La course à la puissance brute finit par se heurter au mur de la mémoire, mais cette puce semble enfin briser ce plafond de verre.
Grâce à une architecture repensée, elle offre des gains de performance par watt qui laissent songeur. Google mise sur une intégration verticale totale pour réduire sa dépendance aux processeurs externes. Ainsi, la bataille contre les puces Blackwell de NVIDIA ne se joue pas seulement sur les téraflops. Cela repose sur l’efficacité globale du réseau Boardfly qui relie ces milliers de puces entre elles.
La stratégie Google TPU v8 face à la concurrence de NVIDIA
Google change radicalement de braquet depuis l’évènement Google Cloud Next 2026 avec la puce TPU v8. Le géant américain veut s’imposer sur le marché avec cette technologie IA qui scinde son architecture pour la première fois. La firme propose alors deux puces distinctes pour répondre à une nécessité de spécialisation. Plus précisément, vous pouvez profiter de la v8t pour l’entraînement et de la v8i pour l’inférence. À vrai dire, cette approche permet de briser le « mur de la mémoire » qui freine les modèles actuels. C’est pourquoi le géant du cloud cherche à offrir une alternative crédible aux GPU NVIDIA Blackwell.
La stratégie de Google repose principalement sur l’ère agentique. C’est un concept où l’IA ne se contente plus de répondre mais agit de manière autonome. Toutefois, une infrastructure sur-mesure devient indispensable pour que ces agents fonctionnent sans latence. Google mise alors sur une intégration verticale totale. Le fait d’avoir le matériel et le logiciel donne un avantage compétitif indéniable sur le coût total de possession. On peut dire que cette autonomie technologique est leur meilleure arme pour garder les clients dans leur écosystème.
Architecture matérielle de la Google TPU v8 : comprendre v8t et v8i
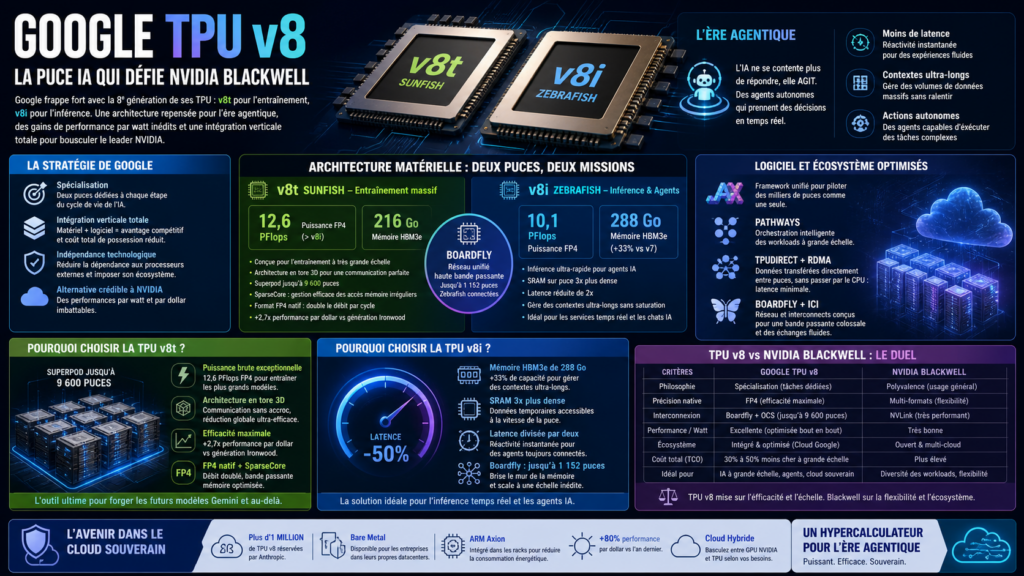
Comme vous le savez déjà, cette nouvelle puce se décline en deux variantes. La marque vise ici à optimiser chaque étape du cycle de vie de l’IA. Pour cela, la TPU v8t, surnommée Sunfish est une bête de somme destinée à l’entraînement. D’un autre côté, la v8i, ou Zebrafish, s’occupe de l’inférence. Grâce à son architecture, la v8t affiche une puissance brute de 12,6 Pflops en précision FP4. Elle peut surpasser les 10,1 Pflops de sa petite sœur dédiée à l’exécution.
Par ailleurs, la v8i n’est pas en reste avec sa mémoire SRAM trois fois plus dense que la génération précédente. Celle-ci intègre 288 Go de mémoire HBM3e, contre 216 Go pour la version entraînement, pour gérer des contextes ultra-longs sans ramer. Notez que Google a intégré le réseau Boardfly qui permet de connecter jusqu’à 1 152 puces Zebrafish entre elles. À première vue, la v8t semble plus puissante. Pourtant, la v8i est cruciale pour l’interactivité des agents IA. Ainsi, cette dernière brise le goulot d’étranglement de la mémoire pour offrir une latence divisée par deux.
Logiciels et IA agentique optimisés par la Google TPU v8
Cette nouvelle puce ne se contente pas d’aligner des composants performants. Elle s’appuie en même temps sur une pile logicielle totalement intégrée. Le secret réside en grande partie dans l’utilisation de JAX et Pathways. Ces frameworks permettent de piloter des milliers de puces comme s’il s’agissait d’une seule entité. Sans cette couche, la gestion des Superpods deviendrait un cauchemar technique. En réalité, Google a conçu cette architecture pour l’ère agentique, où les programmes doivent prendre des décisions en temps réel.
Grâce à l’intégration de TPUDirect et du protocole RDMA, les données circulent sans passer par le processeur central. Par ailleurs, cela réduit la latence lors des communications entre les nœuds. C’est pourquoi les développeurs soulignent l’efficacité des workflows JAX avec cette nouvelle génération. Mais il faut aussi noter que cette optimisation logicielle favorise la montée à l’échelle des modèles les plus gourmands. Finalement, l’infrastructure réseau Boardfly travaille main dans la main avec les interconnects ICI pour fluidifier les échanges.
Pourquoi choisir la Google TPU v8t pour l’entraînement massif ?
La Sunfish est la réponse brutale de Mountain View aux besoins de calcul titanesques. Il faut savoir que son architecture en tore 3D n’est pas là pour faire joli. Effectivement, elle permet une communication parfaite entre les 9 600 puces d’un Superpod. Grâce à cette topologie, les opérations de réduction globale indispensables au parallélisme de données s’exécutent sans le moindre accroc. Google annonce un gain de performance de 2,7 x par dollar par rapport à la génération Ironwood. C’est pourquoi elle devient l’outil privilégié pour forger les futurs modèles Gemini.
En réalité, la force de cette puce réside dans l’utilisation native du format FP4. En passant du 8 bits au 4 bits pour les calculs matriciels, cette Google TPU double le débit par cycle. Cela permet de réduire la taille des tenseurs de travail et de libérer de la bande passante mémoire. Par contre, il ne faut pas oublier le SparseCore. Ce composant spécialisé gère efficacement les accès mémoire irréguliers. C’est ce genre de détail qui évite les goulots d’étranglement que l’on observe souvent sur des processeurs moins spécialisés.
Rumor: Starting with TPU v8, Google will no longer use HBM?
The incident was triggered by the global capacity shortage of HBM, which will be unable to meet AI growth demands over the next 2 to 3 years. At the same time, traditional HBM is limited by its design of being fixed on…
Notez les performances de la Google TPU v8i dans l’inférence des agents
Pourquoi la version Zebrafish est-elle indispensable pour les nouveaux services connectés ? Elle élimine les attentes interminables grâce à une bande passante mémoire colossale. Plus précisément, Google TPU v8i possède une mémoire HBM3e de 288 Go qui représente une hausse majeure par rapport au passé. Cette puce cible en réalité les agents qui doivent jongler avec des contextes très longs. De cette manière, la latence se trouve divisée par deux selon les mesures officielles. Il faut savoir que cette réactivité change complètement l’expérience utilisateur sur les outils de chat.
D’ailleurs, l’ajout d’une mémoire SRAM sur puce trois fois plus dense aide à stocker les données temporaires sans ralentir le flux. En outre, la vraie magie opère avec le réseau Boardfly. Ce dernier permet de relier plus d’un millier de processeurs. Google parvient alors à briser le mur de la mémoire qui bride souvent les processeurs plus classiques. Certes, NVIDIA propose des solutions puissantes. Mais, l’intégration de la Google TPU v8i dans l’écosystème Cloud offre une fluidité difficile à égaler. Par conséquent, le déploiement de modèles comme Gemini devient beaucoup plus rentable pour les entreprises.
Comparaison technique entre Google TPU v8 et NVIDIA Blackwell
Comment situer la puissance de la puce Google face au monstre Blackwell de NVIDIA ? En principe, c’est un duel entre la force brute polyvalente et la spécialisation chirurgicale. Blackwell affiche souvent des pics de performance plus élevés sur le papier. Toutefois, la force de Google réside dans son architecture en essaim. Grâce au réseau Boardfly et à la commutation optique (OCS), la Google TPU v8 peut faire travailler 9 600 puces simultanément.
Par contre, la différence majeure se joue sur la précision des données. Tandis que NVIDIA brille par sa flexibilité sur de nombreux formats. La Google TPU v8 mise tout sur le FP4 natif pour exploser les scores d’efficacité. Mais ne vous y trompez pas, car Blackwell reste le roi incontesté du multi-cloud. Choisir Google, c’est accepter un écosystème fermé en échange de performances par watt imbattables. En principe, le choix d’un professionnel se résume au TCO (Coût Total de Possession). Par conséquent, produire de l’IA à grande échelle coûte souvent 30% à 50% moins cher sur une infrastructure TPU.
Quel avenir pour la Google TPU v8 dans le cloud souverain ?
Où cette nouvelle puce de Google se place-t-elle par rapport à ses rivaux comme l’AWS Trainium ou les solutions Microsoft ? Le géant américain mise en grande partie sur l’hyperspécialisation. En principe, l’accord massif avec Anthropic, qui prévoit d’utiliser plus d’un million de puces, prouve que la demande est là. Dans la pratique, cette infrastructure ne serait plus réservée aux seuls ingénieurs de Google. Plus précisément, la firme commence à proposer ses puces en mode « bare metal ». Son objectif est de permettre aux entreprises d’installer la Google TPU v8 dans leurs propres centres de données. D’une manière général, ce changement de stratégie vise à briser l’hégémonie de NVIDIA sur les serveurs physiques.
De plus, l’intégration des processeurs ARM Axion dans les mêmes racks permet de réduire encore plus la consommation électrique globale. Par conséquent, la performance par dollar fait un bond de 80% par rapport à l’année dernière. Mais ne vous égarez pas, car la force de Google réside aussi dans son cloud hybride. En général, les utilisateurs peuvent basculer entre des GPU NVIDIA pour la flexibilité et des TPU pour le passage à l’échelle. De ce fait, l’écosystème devient un « Hypercalculateur » capable de gérer n’importe quel workload agentique sans sourciller.

 Connexion