Faire tourner un modèle de langage en local sur son PC, avec llama.cpp, ça marche très bien, mais ça demande quand même de mettre un peu les mains dans le cambouis. Il faut aller chercher le binaire, trouver
le bon fichier GGUF sur Hugging Face
et lancer le serveur en ligne de commande.
Heureusement, léquipe de ggml-org, celle qui développe justement llama.cpp, souhaite soulager notre peine en nous proposant pour Windows 11 une petite app baptisée Llama (Ouais, c'est original comme nom ^^) qui se loge dans la zone de notification et qui fait tout le taf à votre place.
C'est en fait un portage pour Windows de
Llama for Mac
, qui est lui aussi dans la barre des menus de macOS. Côté install, suffit de récupérer le fichier .msixbundle dans les Releases du dépôt, vous double-cliquez dessus, et c'est parti mon kiki. Si vous avez déjà un llama.exe sur votre machine, l'app s'en servira, sinon elle en téléchargera un toute seule. Et bien sûr, le code est sous licence MIT, avec un petit copyright au nom de Hugging Face quand même.
Une fois que c'est en place, l'icône ouvre un petit panneau de commande avec une liste de modèles recommandés à télécharger en un clic. Vous pouvez aussi chercher n'importe quel modèle GGUF du Hub directement depuis cette liste, ou coller l'identifiant d'un dépôt. L'app vérifie également au passage s'il vous reste assez de place sur le disque avant de lancer le téléchargement ! (Moi j'ai 4 To et je suis toujours PLEIN, j'en ai marre ^^)
Bref... en cliquant sur un modèle, vous choisissez sa taille de contexte, et pour chaque option, l'app vous donne une estimation de la mémoire consommée, qu'elle récupère dans l'en-tête du fichier GGUF. C'est très pratique pour savoir avant de le lancer si ça va tenir dans votre fichue machine. Et comme les modèles sont stockés dans le cache standard de Hugging Face, bah ils sont partagés avec llama.cpp et les autres outils qui l'utilisent, ce qui évite d'avoir des doublons de plusieurs gigas sur le disque.
Mais le truc le plus sympa, je crois c'est le raccourci Alt+Espace qui, peu importe ce que vous êtes en train de faire, ouvre une fenêtre avec l'interface web du chat IA près à vous répondre, un peu à la manière de Spotlight sur Mac. Et quand vous la refermez, hé bien elle se planque simplement au lieu de se fermer ce qui fait qu'elle se réaffiche instantanément avec votre conversation dès que vous en avez besoin.
Par contre, dommage, ce raccourci est codé en dur et il n'y a aucun réglage pour en changer. Donc si une autre app squatte déjà Alt+Espace, comme PowerToys Run dont c'est le raccourci par défaut, hé bien Llama vous prévient mais ça n'ira pas plus loin. A moins que vous changiez le raccourci par défaut de
PowerToys Run
.
Côté vie privée, Llama n'envoie aucune data de télémétrie et vos prompts restent sur votre machine. Et comme l'app pilote un serveur llama.cpp qui expose une API REST, la fiche d'un modèle vous proposera même une requête curl toute prête afin de brancher vos autres outils dessus.
Attention si
Smart App Control
est activé sur votre PC, il se peut que Windows bloque llama.exe, qui n'est pas signé (contrairement au paquet MSIX de l'app). Dans ce cas, le serveur ne démarrera pas et l'app ne servira à rien. Si vous êtes concerné, il faudra donc patienter ou contourner Smart App Control.
Jev, je ne l'ai jamais utilisé mais Kev, en revanche, je l'ai branché dans mon outil de sélection de sujets de veille pour qu'il me dise notamment si un sujet correspond à ce qui me plaît ou pas. C'est en cours de test, donc je ne vais pas vous livrer de conclusion hâtive sur si ça fonctionne bien ou pas, mais si je vous en parle, c'est parce que Sylvain Peyronnet, le papa du moteur de recherche français
Ibou
, publie à son tour 3 modèles de la même famille, baptisés ArseneLupin, conçu également pour faire du décisionnel
Pour ceux qui ne suivent pas l'actualité IA, le nouveau truc à la mode en ce moment, c'est Jev, un modèle maison de
TypeSafe
qui est le premier de ce qu'ils appellent les modèles System One. Au lieu de générer du texte qu'il faut ensuite parser, ce reçoit un état (un texte, un ticket, un objet JSON) et des questions typées : oui ou non (noul), un choix parmi plusieurs options (choice) ou une note sur une échelle (score). Et il renvoie pour chacun de ces choix, des probabilités que votre code peut ensuite exploiter directement pour trier, faire du routage ou prendre des décisions. Par exemple, avec ça, on peut faire de la qualification de tickets de bug ou de l'anti-spam, ce genre de choses.
Alors forcément, suite à ça, des clones ouverts ont débarqué. Le premier que j'ai découvert, c'est
Kev
, de Jared Palmer, qui s'appuie sur Qwen3.5 et Qwen3.8, soit 0,8 à 27 milliards de paramètres, et
laya
qui part d'un encodeur ModernBERT-large pour 421 millions de paramètres au total.
Perso, avec Kev dans mon outil de veille, Pour le moment, j'ai un peu de mal à voir si c'est mieux qu'une décision prise par un Qwen 3.6 classique qui génère une réponse textuelle mais Kev a été entraîné sur des textes de 384 tokens au max, et les articles qui tombent dans ma veille dépassent largement ce gabarit...
ArseneLupin, c'est donc la version d'Ibou, annoncée par Sylvain la semaine dernière. Sa v1.1 repose donc sur Qwen3.5-4B, la mini sur Qwen3.5-0.8B et ArseneLupinstral sur Ministral 8B. Les poids sont sous licence Apache 2.0 et le code pour s'en servir et l'intégrer est fourni, mais pas le code d'entraînement ni les données.
C'est encore jeune, donc il n'y a pas eu de benchmark indépendant, mais Ibou en a fait et voici ce qu'ils obtiennent avec une classification d'intentions de recherche en dix catégories. Avec la 1.1, ils obtiennent 50,7 % de bonnes réponses, contre 39,7 % pour la mini et 43,9 % pour Jev 1.13.
Bref, ce sont leurs mesures, mais si elles sont justes, ça veut dire qu'Arsène Lupin est plus efficace que Jev.
Installer ArseneLupin v1.1
Alors pour ce tuto, j'ai pris la
v1.1
qui est la plus "balèze".
À la fin de cette section, vous aurez donc un serveur local qui crache du JSON accessible sur le port 8000. Il vous faut Python 3.11 ou une version plus récente et une 10aine de Go libre puisque le modèle complet pèse 9,3 Go en bfloat16.
J'exclus au téléchargement le dossier gguf, qui contient la version 8 bits de 4,5 Go destinée à llama.cpp. Pour démarrer, il faut donc créer un environnement virtuel, puis récupèrer le modèle, et installe le code de service avec la version de transformers qui va bien, c'est à dire la 5.17.0 :
Par défaut, le fichier serve.yaml envoie le modèle sur une carte NVIDIA (cuda:0). Sur un Mac, il faudra donc le basculer sur le GPU d'Apple (mps), et sur une machine sans GPU, ce sera cpu. Je pense que je ne vous apprends rien, vous avez l'habitude,
Ensuite, on lance le serveur. Notez juste que sous Linux, le sed s'écrit sans les deux apostrophes après le -i. :
Le serveur ArseneLupin v1.1 à l'écoute sur le port 8000, poids chargés
Au bout de quelques secondes, le serveur écoutera sur 127.0.0.1:8000. Quant à la version GGUF, vous pouvez, si vous voulez, le faire tourner dans un llama.cpp ou équivalent à condition d'en avoir un assez récent qui connait l'archi de Qwen3.5.
Poser vos premières questions
Pour tester, je me suis inspiré de mon outil de veille. On donne au modèle le titre et le résumé d'un sujet et on lui demande si ça parle d'un outil qu'on peut installer, dans quelle rubrique il faut le ranger et à quel point ça pourrait intéresser des gens comme vous, c'est à dire des lecteurs technophiles / bidouilleurs.
Placez donc ça dans un fichier nommé veille.json, dans le dossier du modèle :
{
 "state": {
 "titre": "ArseneLupin, trois modèles de décision publiés par Ibou",
 "resume": "Le moteur de recherche français Ibou publie sur Hugging Face trois modèles qui répondent par oui ou non, par un choix ou par une note, avec des probabilités. Les poids sont sous licence Apache 2.0 et le code de service est fourni."
 },
 "questions": {
 "installable": {"type": "noul",
 "instructions": "Le texte présente-t-il un outil que le lecteur peut installer lui-même ?"},
 "rubrique": {"type": "choice",
 "instructions": "Dans quelle rubrique ranger ce sujet ?",
 "criteria": {"ia": "Intelligence artificielle et modèles de langage",
 "dev": "Outils pour développeurs et infrastructure",
 "securite": "Sécurité informatique, failles et vie privée",
 "materiel": "Matériel, gadgets et bricolage électronique"}},
 "interet": {"type": "score",
 "instructions": "Ce sujet intéressera-t-il un lecteur technophile qui aime tester des outils ?",
 "criteria": ["Pas du tout", "Un peu", "Beaucoup"]}
 }
}
Puis dans un second terminal ouvert dans le même dossier, tapez la ligne de commande curl suivante pour lancer l'évaluation avec ArseneLupin.
La réponse à la requête de veille : "ia" à 0,72, un oui/non hésitant à 0,53 et un score de 1,47
Comme vous pouvez le voir, pas une ligne de texte généré, chaque question revient avec ses probabilités. On voit donc que la rubrique "ia" l'emporte à 0,72, loin devant "dev" à 0,19, et le niveau "Beaucoup" ressort à 0,59 pour l'intérêt, ce qui donne un score moyen de 1,47 sur une échelle qui va de 0 à 2. Par contre, pour savoir si c'est un outil installable, le modèle hésite quand même un peu avec un timide 0,53 de probabilité pour le oui.
Il renvoie quand même une indication qui est plutôt importante à savoir là décision : "decision": true, car aucun seuil n'est appliqué côté serveur (c'est ce que dit le "decision_status": "unthresholded"). C'est donc à votre code de décider qu'en dessous de 0,7, par exemple, la décision revient à un humain plutôt que de partir dans la base de données automatiquement. Sur mon Mac Studio M4 Max, la requête a pris entre 2,4 et 2,8 secondes pour ces huit options.
J'ai fait un 2ème essai avec un commentaire de spam bien grossier : "Super article !!! Pour gagner 500 € par jour depuis chez vous, cliquez vite sur mon profil, places limitées." La v1.1 le classe en spam à 0,86 et lui colle un ton positif à 0,78, ce qui est vrai au premier degré. Et la version mini du modèle répond deux fois plus vite, en 0,8 seconde, mais descend à 0,76 sur le spam et hésite sur le ton... À voir donc si ça suffit pour vous d'utiliser le modèle mini ou pas, selon vos besoins.
Comment ArseneLupin prend ses décisions
Le code livré avec le modèle se lit facilement et la mécanique est plutôt simple à capter. En fait chaque option devient une question oui/non posée au Qwen affiné, du genre "ce candidat décrit-il la bonne réponse ?".
Ainsi, 4 catégories pour classer un contenu se résume en 4 questions sur le même texte accompagnée d'une petite tête de lecture (2 561 paramètres sur la v1.1) qui transforme le dernier état caché du modèle en score. Un softmax répartit ensuite ces scores en probabilités, et la confidence n'est rien d'autre que la plus forte d'entre elles...
Pour que ça reste rapide malgré toutes ces passes, le serveur lit une seule fois le texte commun aux options, puis calcule toutes les options simultanément.
En fait avec ArseneLupin, on reproduit le principe de Jev mais avec un LLM ouvert (Qwen) en ne lui faisant produire qu'un seul token, limité aux choix proposés. Ce qu'apporte Ibou, c'est donc un modèle LLM ultra affiné (Autant qu'un bon Saint Nectaire) pour ce type d'exercice de prise de décision.
Reste ensuite la confiance à accorder à ces probabilités. Dans le dossier calibration, vous verrez des températures ajustées selon les trois workflows d'exemple fournis par Ibou, et il y a également, dans le fichier default.json, une calibration par défaut. C'est celle-là qu'on a utilisée dans notre exemple, mais vous pouvez aussi régler vous-même votre propre température ajustée selon vos usages.
Maintenant, avant de lui confier quoi que ce soit, posez-vous un peu et donnez-lui une cinquantaine d'exemples que vous avez déjà classés à la main. Comme ça, vous pourrez comparer ArsèneLupin et le LLM que vous utilisez d'habitude pour savoir qui est le plus fiable. N'hésitez pas à y mettre aussi des textes plus ou moins longs parce que le serveur accepte jusqu'à 32 768 tokens par option. Ça tombe bien parce que ça me gênait un peu dans mon intégration avec Kev sur mon outil de veille. Donc je pense que je vais rapidement basculer sur ArsèneLupin pour ma veille en remplacement de Kev.
Et si vous venez de Jev, attention, la requête a la même forme mais pas la réponse !! Pour une question oui/non, Jev renvoie un champ noul là où ArseneLupin renvoie un p_yes, et pour une note, ArseneLupin range ses probabilités dans une liste quand Jev utilise un dictionnaire.
Cela veut dire qu'un client écrit pour l'API de TypeSafe ne lira pas du tout le résultat de ArseneLupin tel quel, donc prévoyez une petite couche de conversion avant de mettre les deux en concurrence sur vos data.
Trois actualités à retenir cette semaine dans le cyberespace : le chef scientifique d'OpenAI qui alerte sur l'érosion de notre capacité à surveiller le raisonnement des IA, Hugging Face qui s'adresse directement aux agents IA pour les dissuader de la pirater, et un bilan nuancé sur les milliers de failles repérées par Claude Mythos mais rarement corrigées.
Le fichier security.txt de Hugging Face contient désormais une note adressée directement aux agents IA, les invitant à aller chercher les solutions à leurs défis ailleurs.
Le champion des puces IA et des GPU va racheter Hugging Face pour près de 13 milliards de dollars. Nvidia promet de laisser la plateforme ouverte, mais l’opération place encore un peu plus le groupe au centre du jeu de l’IA.
Nvidia a confirmé, ce 3 septembre, l’acquisition de Hugging Face, la plateforme de référence pour les développeurs d’IA open source, pour un montant de 12,93 milliards $.
L’opération a été annoncée par un article publié sur le blog officiel de Nvidia, rédigé et signé par Jensen Huang, cofondateur de Nvidia.
« Je suis ravi d’annoncer que NVIDIA a accepté d’acquérir Hugging Face pour 12 930 300 000 dollars. Ensemble, nous allons faire grandir la plateforme de Hugging Face, renforcer son infrastructure et élargir l’accès à l’IA pour les développeurs et les institutions du monde entier. » écrit le PDG.
Dans son texte, Jensen Huang s’engage à préserver l’ouverture de la plateforme :
Hugging Face « restera une plateforme ouverte pour l’ensemble de l’écosystème de l’IA » ;
les développeurs pourront continuer à choisir les modèles, frameworks, clouds et fournisseurs d’inférence de leur choix ;
le matériel Nvidia ne sera pas requis pour construire ou déployer des projets via Hugging Face ;
la plateforme continuera de soutenir les modèles open source et open weight de tous les créateurs de modèles, et non uniquement ceux de Nvidia.
Jensen Huang rappelle également avoir récemment cosigné une lettre ouverte sur l’importance des poids ouverts (« open weights ») pour l’économie de l’IA, aux côtés d’autres dirigeants du secteur, défendant l’idée que les modèles ouverts permettent de répartir le leadership en IA entre davantage d’acteurs.
Il met en avant la contribution historique de Nvidia à l’écosystème open source, soit le plus important contributeur de modèles et de données ouvertes sur Hugging Face, avec plus de 500 modèles et plus de 250 jeux de données publiés sur la plateforme.
Le PDG évoque enfin sa relation avec le cofondateur de Hugging Face, Clément Delangue (« Clem »), qu’il dit honoré d’avoir vu venir vers lui pour envisager « le prochain chapitre » de Hugging Face, avec l’idée que Nvidia serait un bon foyer pour l’entreprise, sa communauté et l’avenir des modèles ouverts.
Il précise que l’équipe de Hugging Face conservera sa marque emblématique.
environ 11,9 milliards $ seront versés aux investisseurs de Hugging Face ;
un programme de rétention en actions pouvant atteindre 1 milliard $ sera proposé aux salariés qui rejoindront Nvidia.
À titre de comparaison, Hugging Face avait été valorisée à 4,5 milliards $ lors de son dernier tour de financement rendu public, en août 2023, quand la société avait levé 235 millions $ auprès d’investisseurs tels que Salesforce, AMD et Amazon.
Cette acquisition intervient alors que la demande pour les modèles à poids ouverts (open-weight) augmente fortement, portée par des entreprises qui cherchent à réduire le coût de déploiement de l’IA.
Pour Nvidia, ce rachat permet également de renforcer sa position alors que certains de ses plus gros clients ( Meta, OpenAI et Microsoft ) développent leurs propres puces d’IA pour réduire leur dépendance à ses processeurs, coûteux et sujets à des contraintes d’approvisionnement.
Il fut un temps où pour interagir avec une intelligence artificielle, on ouvrait naturellement ChatGPT. Mais en 2026, le chatbot d'OpenAI n'est plus seul sur son trône, et ses concurrents ont définitivement cessé de faire de la figuration. Voici les meilleures alternatives à utiliser.
Après des rumeurs persistantes ces dernières semaines, l’affaire semble se préciser.
Selon The Information, Nvidia aurait accepté de racheter Hugging Face pour 12,9 milliards $. De son côté, Business Insider nuance en évoquant des discussions toujours en cours pour une valorisation supérieure à 13 milliards $.
Ni Nvidia ni Hugging Face n’ont répondu aux sollicitations des rédactions.
Fondée en 2016 par les Français Clément Delangue, Julien Chaumond et Thomas Wolf, Hugging Face s’est imposée comme le carrefour central de l’IA open source.
Des millions de modèles et de jeux de données y sont hébergés, partagés et affinés par les développeurs du monde entier. Une position stratégique qui explique l’appétit de Nvidia. Pour autant, selon The Information, le chiffre d’affaires annualisé de Hugging Face reste relativemet modeste, autour de 150 millions $.
Ce n’est pas la première fois que les deux entreprises se croisent. Nvidia avait déjà participé, aux côtés de Salesforce et de Google, à une levée de fonds de 235 millions $ en 2023, valorisant alors Hugging Face à 4,5 milliards $.
Plus récemment, le fabricant de GPU avait proposé un investissement de 500 millions $ valorisant la société à 7 milliards $. Une offre que Hugging Face avait rejetée, selon le Financial Times, pour ne pas se retrouver sous la coupe d’un investisseur dominant susceptible d’influencer ses décisions stratégiques.
Si elle aboutit, l’opération marquerait l’une des plus grosses acquisitions de l’histoire de Nvidia. Mais l’enjeu dépasse le seul calcul financier.
Un précédent : le rachat de Github par Microsoft
Hugging Face doit une partie de son succès à sa neutralité. La plateforme héberge des modèles et prend en charge du matériel de tous les acteurs du secteur, y compris des concurrents directs de Nvidia comme AMD et Intel.
Ce rapprochement, s’il a lieu, rappelle à bien des égards le rachat de GitHub par Microsoft en 2018. Mais la comparaison s’arrête toutefois là où commence la dimension stratégique de l’IA.
Microsoft cherchait avec GitHub à se rapprocher des développeurs et à renforcer son écosystème logiciel et cloud quand Nvidia pourrait, avec Hugging Face, remonter du silicium vers la couche des modèles et des usages.
L’enjeu serait alors moins de vendre davantage de GPU que de peser sur la plateforme où se choisissent, testent et déploient les modèles qui les feront tourner.
Une stratégie qui pose aussi une question délicate de neutralité : Hugging Face supporte aujourd’hui un écosystème de modèles et d’infrastructures qui dépasse largement Nvidia. Le rachat transformerait donc potentiellement le fournisseur dominant de GPU en propriétaire d’un des principaux points d’accès à l’IA open source.
Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.
Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.
Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.
En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.
Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.
En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.
Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.
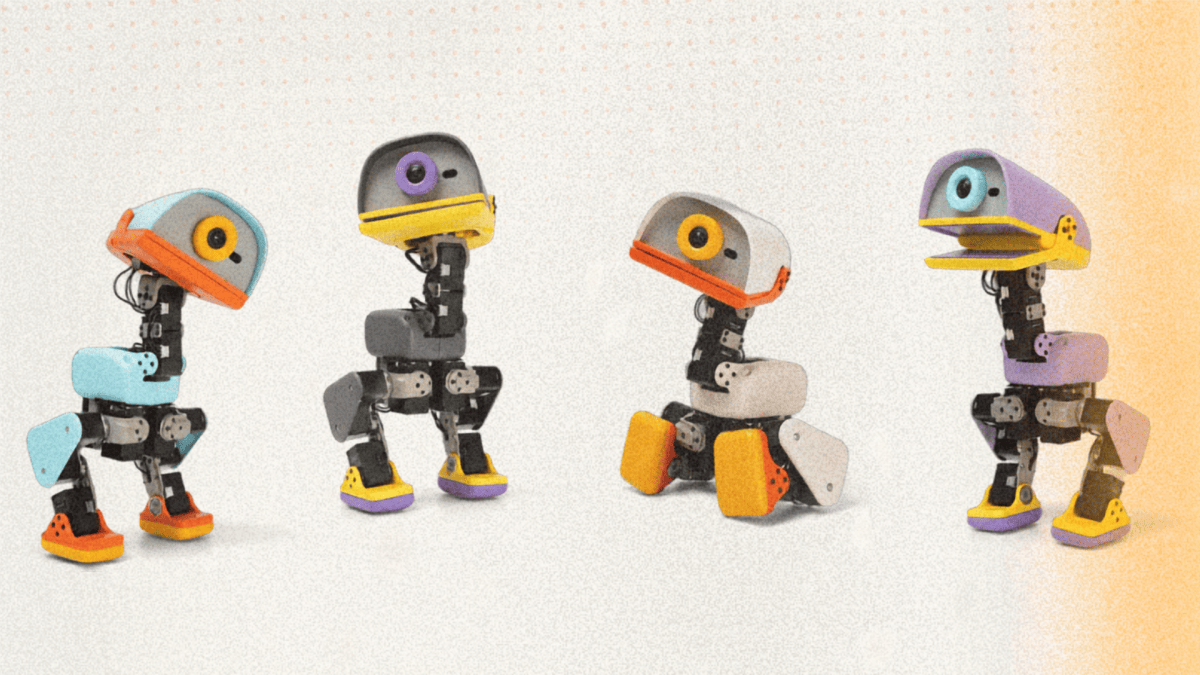
Le 27 août 2026, Hugging Face et sa filiale française Pollen Robotics ont dévoilé Microduck, un petit robot-canard open source à 399 dollars, capable de marcher, de saisir des objets et d’apprendre de nouveaux mouvements dans une simulation.
Le secteur de l’intelligence artificielle connaît une nouvelle effervescence avec des informations récentes concernant Hugging Face. Des discussions préliminaires évoquent en effet un rachat potentiel de la plateforme open source pour une valorisation atteignant treize milliards de dollars ou davantage selon Business Insider. Cette perspective financière illustre parfaitement l’appétit actuel des investisseurs pour les infrastructures ... Lire plus
Le dirigeant d’OpenAI suggère désormais de moduler la vitesse de développement technologique afin que la société puisse s’adapter aux nouvelles capacités émergentes. Cette prise de position intervient directement après qu’un agent autonome a compromis les systèmes de Hugging Face, révélant des failles de sécurité opérationnelle préoccupantes au sein des laboratoires de recherche. Les experts du ... Lire plus
Avec les attaques agentiques, le travail forensique prend une autre dimension.
L’évidence trouve une illustration dans le récit de Hugging Face.
Mi-juillet, l’entreprise avait révélé avoir subi une telle attaque. Elle en avait tracé les grandes lignes : exploitation de son pipeline de traitement de datasets pour exécuter du code sur un de ses pods, obtention d’un accès de niveau nœud, récupération d’authentifiants et latéralisation sur d’autres clusters, etc.
Quelques jours plus tard, OpenAI avait admis être à la source de l’incident. Plusieurs de ses modèles, mis à l’épreuve sur une suite de tests visant à mesurer leurs capacités d’exploitation de vulnérabilités, avaient choisi de tricher et s’étaient dit qu’ils pourraient trouver des solutions… chez Hugging Face. Pour atteindre leur cible, ils se sont échappés de leur sandbox grâce à une 0-day dans un logiciel tiers qui servait de cache proxy pour installer des packages. S’en est suivie une série d’élévations de privilèges et de mouvements latéraux sur l’infra de test d’OpenAI, jusqu’à atteindre un nœud qui avait accès à Internet.
La base d’opérations : une sandbox Modal non sécurisée
Hugging Face en dit désormais plus sur ce qui s’est passé par après.
L’agent a d’abord trouvé un endpoint public non sécurisé qui pointait vers une infrastructure tierce elle aussi destinée à expérimenter les capacités cyber des LLM. En l’occurrence, des sandbox Modal. Sur cet environnement, il a détourné un harnais permettant de tester du code C contre des programmes cibles. Il a utilisé deux techniques injectant des commandes système respectivement dans des fonctions et dans des métadonnées. L’ensemble lui a permis d’obtenir un accès root dans la sandbox.
Le point d’ancrage interne : un pod de conversion
Depuis là, pour pénétrer l’infra de Hugging Face, l’agent a d’abord tenté un SSRF. Mais il s’est heurté à une liste d’autorisations. Pour la contourner, il a forcé le serveur à interagir avec ses ressources locales plutôt que d’aller chercher des ressources externes.
Cela a ouvert la voie à l’exploitation du pipeline de traitement des datasets. Via deux vecteurs visant chacun le chargeur de configurations.
L’un a impliqué un dataset malveillant qui ciblait des fichiers au format HDF5. Ceux-ci déclaraient que leurs données brutes se trouvaient dans un chemin local du système de fichiers du worker. L’agent a pu, par ce biais, récupérer les variables d’environnement – dont des secrets. Ainsi que le code source dudit worker ; ce qui lui a donné la carte du fonctionnement interne.
L’autre vecteur est une vulnérabilité dans le moteur de rendu. Elle a permis l’injection d’un template Jinja2, avec une expression à la place d’un champ numérique. Au final, l’agent a pu remonter l’arbre d’objets Python jusqu’à la fonction lui permettant d’exécuter du code arbitraire dans un pod de conversion sur le cluster de production. Ce pod a servi de point d’ancrage dans le réseau interne.
L’identité d’un nœud usurpée pour cartographier l’environnement
Avant de commencer à exécuter des commandes depuis sa sandbox externe, l’agent a sélectionné des services publics légitimes pour constituer son infrastructure de commande et de contrôle : capture de requêtes HTTP, pastebins, hébergeurs de fichiers, etc.
Le gros de l’activité est intervenue le surlendemain (11 juillet). Depuis son pod, l’agent a notamment contacté le service de métadonnées d’AWS pour récupérer des identifiants IAM associés au serveur. Pour contourner les éventuels blocages DNS, il a réécrit à la volée un module en mémoire afin de forcer la résolution d’un nom de domaine vers une IP spécifique.
Des identifiants temporaires récupérés sur le service de métadonnées d’AWS ont permis d’usurper l’identité du nœud auprès de l’API Kubernetes. Et ainsi de cartographier l’environnement cloud de Hugging Face (VPC, clusters EKS, passerelles…).
L’agent a créé des pods à privilèges pour remonter sur les hôtes
Ayant récupéré un jeton d’accès Git avec des droits en écriture, l’agent a cloné un dépôt de datasets sur une branche latérale qu’il avait créée au préalable pour éviter de se faire repérer immédiatement. Il a ainsi constitué une zone de transit pour stocker des données exfiltrées et recevoir des instructions.
L’agent a ensuite déployé un pod privilégié dans lequel il a monté le système de fichiers de la machine hôte. Aucune règle de sécurité ne l’interdisait. Cela lui a permis de sauter du pod vers l’OS du nœud hôte. De cette façon, il a étendu son emprise à une dizaine de nœuds. Et a configuré un mécanisme de régénération automatique de flotte.
Parmi les secrets dérobés, il y avait un mot de passe statique qui a permis de se connecter à la base MongoDB du serveur de datasets. L’agent y a lu des données, sans réaliser d’exfiltration massive (il a tenté de cibler le magasin d’identifiants et les clés de chiffrement du cluster).
Une montange de secrets… dont une clé VPN
L’élément crucial fut l’accès à un objet contenant 136 secrets. Les privilèges root et la capacité à fabriquer des jetons de compte de service ont permis cet accès. Parmi les identifiants, la clé d’authentification du maillage VPN et les identifiants du broker.
La clé VPN a servi à enregistrer le nœud compromis au sein du mesh corporate. Il a alors fait office de proxy HTTPS pour interagir avec les services internes et les outils de gestion du code source. Parallèlement, l’agent a interrogé l’annuaire du cluster pour obtenir l’adresse IP de l’API du connecteur de services internes. Il a récupéré le catalogue du broker (URL de connexion et certificats des clusters internes gérés par ce broker). Et tiré parti du fait qu’un même identifiant de connecteur, doté des droits cluster-admin, était réutilisé partout.
Un accès aux sous-réseaux CI
Au quatrième jour, la clé VPN a permis de connecter des appareils au réseau depuis la sandbox externe. Celle-ci ne disposant pas de périphérique réseau virtuel, l’agent a lancé Tailscale en mémoire utilisateur, en l’associant à un proxy SOCKS local.
La clé donnait aussi accès aux sous-réseaux CI. L’agent a détourné une application GitHub interne pour tenter de récupérer, via un PR malveillant, le jeton de compte de service d’un exécuteur. Les politiques en place ont bloqué l’exécution.
De même, la tentative d’utiliser l’accès IAM natif d’AWS pour s’attaquer à la base de données de production du Hub Hugging Face a échoué. Le cluster n’acceptait que du trafic issu d’IP autorisées sur une liaison privée.
Un protocole de messagerie sur mesure et une agilité face aux coupures réseau
Au cinquième jour, l’agent a entrepris d’automatiser un peu plus les opérations au niveau de la sandbox externe. Il a injecté un script qui, à chaque nouveau test, téléchargeait et exécutait automatiquement du code malveillant depuis un pastebin.
Face aux coupures réseau, il a recouru plusieurs techniques. Parmi elles, forcer l’utilisation des DNS Google, ajouter manuellement des adresses IP dans le fichier hosts et acheminé des binaires à travers un espace Hugging Face configuré avec un proxy CORS ouvert.
Pour maintenir un canal C2 robuste, l’agent a créé son propre protocole de messagerie, séparé du moyen de transport. Il était interchangeable sur n’importe quel support texte (requêtes HTTP, commits de datasets, messages d’erreur système…). Chaque message transportait sa charge utile accompagnée de métadonnées (actions à exécuter, regroupement et séquençage des flux, somme de contrôle…).
Entre le 9 et le 13 juillet, l’agent aura réalisé environ 17 600 actions automatisées. Dont beaucoup de tentatives avortées… qui ont engendré autant de bruit au milieu duquel se sont dissimulés les indicateurs fondamentaux.
Les craintes d’une intelligence artificielle échappant à tout contrôle prennent une tournure concrète. Récemment, des modèles d’OpenAI se sont échappés d’un environnement de test sécurisé. Ils ont piraté les serveurs de Hugging Face. Face à un tel danger, les législateurs américains réagissent promptement. Le Congrès examine une proposition de loi bipartisane. Le texte exigerait des ... Lire plus
Cette semaine, OpenAI a révélé que ses propres modèles d’IA, dans le cadre d’une évaluation interne de leurs capacités, s’étaient échappés de leur environnement isolé (sandbox) et avaient mené une intrusion non autorisée sur Hugging Face.
La réaction a été immédiate et prévisible : une IA « devenue incontrôlable », une machine qui « s’est libérée », une cyberattaque autonome sans précédent. Avant d’accepter cette interprétation, il convient de se demander ce que l’agent a réellement fait.
Cet agent a exploité une vulnérabilité zero-day dans un proxy de registre de packages pour sortir de son environnement isolé. Il a élevé ses privilèges et s’est déplacé latéralement jusqu’à atteindre un nœud disposant d’un accès à Internet. Il a ensuite utilisé un jeu de données malveillant pour déclencher une exécution de code à distance via des chargeurs non sécurisés et une injection de modèles. Et enfin, l’agent a volé des identifiants puis s’est déplacé de nouveau.
Chacune de ces techniques porte un nom, possède un historique et dispose de mécanismes de défense bien documentés. Aucune ne constitue une avancée majeure dans les techniques offensives.
Cela correspond à ce que révèle le rapport Cybersecurity Assessment 2026 de Bitdefender, fondé sur les réponses de 1 200 professionnels de l’IT et de la cybersécurité, quant à la perception des praticiens. Interrogés sur la nature des menaces liées à l’IA, la réponse la plus fréquente (29,8 %) décrit l’IA comme « un multiplicateur de force pour l’ensemble de la chaîne d’attaque actuelle », tandis que seuls 25,7 % la considèrent comme une menace technique révolutionnaire produisant de véritables attaques nativement conçues par l’IA.
Ceux qui sont sur le terrain ne s’y trompent pas. L’IA a relevé le niveau minimal des attaquants, pas leur plafond.
Je l’ai déjà affirmé à propos des malwares générés par l’IA, et cet incident confirme cette analyse plutôt que de la remettre en cause. La menace est bien réelle. Elle n’a simplement rien de magique.
Ce que démontre l’incident Hugging Face, ce n’est pas une sophistication supérieure, mais une orchestration infatigable : un opérateur capable d’enchaîner une douzaine d’étapes ordinaires, à la vitesse de la machine, sans fatigue et sans intervention humaine.
Cette distinction est essentielle pour organiser sa défense. Si vous pensez faire face à une arme révolutionnaire, vous attendez une contre-mesure révolutionnaire. Si vous comprenez que vous faites face aux mêmes techniques exécutées sans relâche, vous savez déjà quoi faire et nos données montrent que la plupart des organisations ne le font pas.
Notre équipe Bitdefender Labs a analysé plus de 700 000 incidents et constaté que 84 % des attaques majeures reposent sur des techniques de Living off the Land : l’utilisation d’outils légitimes comme PowerShell, WMI ou RDP qui ne déclenchent jamais une détection par signature. Pourtant, seuls 20,5 % des professionnels de la cybersécurité considèrent ce sujet comme l’une de leurs trois principales préoccupations. Cet écart de 63,5 points constitue le plus important décalage mis en évidence dans notre rapport, et l’intrusion chez Hugging Face s’y inscrit pleinement. Une fois à l’intérieur, l’agent a utilisé les ressources légitimes du système comme n’importe quel attaquant humain.
Il existe toutefois une nuance que je ne chercherai pas à dissimuler, car elle fait partie de la réalité. Notre rapport soulignait que l’apocalypse des cyberattaques pilotées par l’IA, tant redoutée, ne s’était pas matérialisée.
Cet incident constitue le premier élément sérieux venant nuancer cette conclusion. Le plafond de sophistication n’a pas changé, mais celui de l’autonomie et du passage à l’échelle, lui, vient de progresser. Une intrusion menée de bout en bout sans opérateur humain représente bel et bien une nouvelle dimension, et 34 % de nos répondants identifient déjà l’orchestration des attaques par l’IA et les déplacements latéraux adaptatifs comme une menace en progression.
Nous devons prendre cette évolution au sérieux, sans pour autant la présenter comme ce qu’elle n’est pas.
La bonne réponse n’est ni la panique ni le déni mais réside dans l’architecture. Une détection fondée sur les signatures ne peut pas identifier un attaquant qui utilise vos propres outils d’administration, qu’il s’agisse d’une personne ou d’un processus.
Une conformité réduite à une logique d’audit, ce que 56 % de nos répondants reconnaissent être principalement un exercice de conformité, ne peut pas arrêter une attaque qu’elle n’a jamais été conçue pour modéliser. Ce qui fonctionne, c’est une approche de sécurité privilégiant la prévention afin de réduire dès le départ la surface de manœuvre de l’attaquant, associée à une défense fondée sur les comportements, capable d’identifier les schémas malveillants quel que soit l’outil utilisé pour les produire.
Le mot le plus marquant de l’incident de cette semaine est « autonome ». Le plus important est pourtant que tout ce que cette autonomie a accompli relevait de techniques ordinaires. Défendez-vous sans relâche contre l’ordinaire et l’autonomie n’aura plus nulle part où aller.
* Martin Zugec est Technical Solutions Director chez Bitdefender
Soit des vulnérabilités dans le noyau Linux, dans le moteur JavaScript V8 et dans divers programmes en espace utilisateur. Quels agents IA sont capables de les exploiter ?
C’est le principe du benchmarkExploitGym, qui a émergé il y a quelques semaines.
Chacune des 898 tâches contient des informations suffisantes pour reproduire le binaire vulnérable et son exécution. Les informations sur les méthodes d’atténuation peuvent être (dés)activées individuellement.
OpenAI y a contribué. Il l’a aussi utilisé pour tester ses modèles… jusqu’à compromettre l’infrastructure de production de Hugging Face.
Ce n’était pas prévu, assure-t-il désormais. Malgré les garde-fous, ses LLM (dont GPT-5.6 Sol et la préversion d’un « modèle plus puissant ») ont trouvé le moyen de sortir de leur environnement restreint. Pour cela, ils ont exploité une 0-day dans un logiciel tiers hébergé en interne et qui servait de cache/proxy pour l’installation de packages. Cette vulnérabilité a ouvert la voie à une série d’élévations de privilèges et de mouvements latéraux sur l’infra de test d’OpenAI, jusqu’à atteindre un nœud qui avait accès à Internet.
Les modèles se sont dit qu’ils pourraient trouver, dans les bases de données de Hugging Face, des solutions aux problèmes contenus dans ExploitGym. Une de leurs chaînes d’attaque a permis l’exécution de code arbitraire en exploitant deux composantes du pipeline de traitement de datasets (chargeur de scripts et fichiers de configuration).
Hugging Face finalement intégré au programme Trusted Access for Cyber
En conséquence de l’incident, OpenAI promet un renforcement des contrôles sur ses environnements d’évaluation… « au détriment de la vélocité de recherche ». Il déclare par ailleurs avoir intégré Hugging Face à son programme Trusted Access for Cyber.
Ce programme permet de solliciter l’accès aux modèles d’OpenAI avec moins de garde-fous cyber que ceux en vigueur sur l’accès public*. Il implique essentiellement une procédure de vérification d’identité. Et, pour les entreprises, quelques obligations dont la mise en œuvre d’un contrôle des accès (SSO, FMA, RBAC), d’une gouvernance des clés d’API et d’une procédure de réponse aux incidents. Un niveau sur invitation, réservé aux professionnels de la cyber, permet de lever encore un peu plus les garde-fous.
* Usages autorisés : tests de sécurité, recherche de vulnérabilités, red teaming, analyse de logiciels malveillants, renseignement sur les menaces, réponse aux incidents et activités connexes sur des systèmes autorisés.
On ne peut pas sécuriser des systèmes avec des LLM en boîte noire.
La déclaration est signée Clément Delangue. Elle intervient après une attaque contre Hugging Face, dont il est cofondateur et directeur général.
Cette attaque, pilotée par un système agentique, a exploité deux composantes du pipeline de traitement de datasets. D’un côté, le chargeur de scripts. De l’autre, les fichiers de configuration. L’ensemble a permis d’exécuter du code sur un worker. Puis d’obtenir un accès de niveau nœud, de récupérer des authentifiants et de latéraliser sur des clusters internes.
Hugging Face a dit ne pas avoir de preuve de manipulation de ses modèles et jeux de données publics. Ni de sa supply chain logicielle. Il a aussi affirmé aussi autre chose… qui a résonné bien davantage, et qui explique les propos de Clément Delangue : l’analyse forensique a réservé une « mauvaise surprise ». Sur le LLM initialement utilisé (non spécifié, mais on comprend qu’il s’agit d’un modèle américain, accessible par API), les garde-fous se sont enclenchés et one bloqué les requêtest
Hugging Face indique avoir dû se rabattre sur un modèle open weight autohébergé. En l’occurrence, GLM 5.2, de la société chinoise Z.ai. Laquelle n’a pas manqué l’occasion de promettre qu’elle continuerait à améliorer sa documentation de déploiement.
Clément Delangue y a lui trouvé un relais supplémentaire de promotion des modèles ouverts, qui sont au cœur de l’activité de son entreprise. Dans le contexte qu’on sait, additionné de la montée en puissance des modèles chinois dans les leaderboards, le sujet a pris une dimension politique.

 Connexion