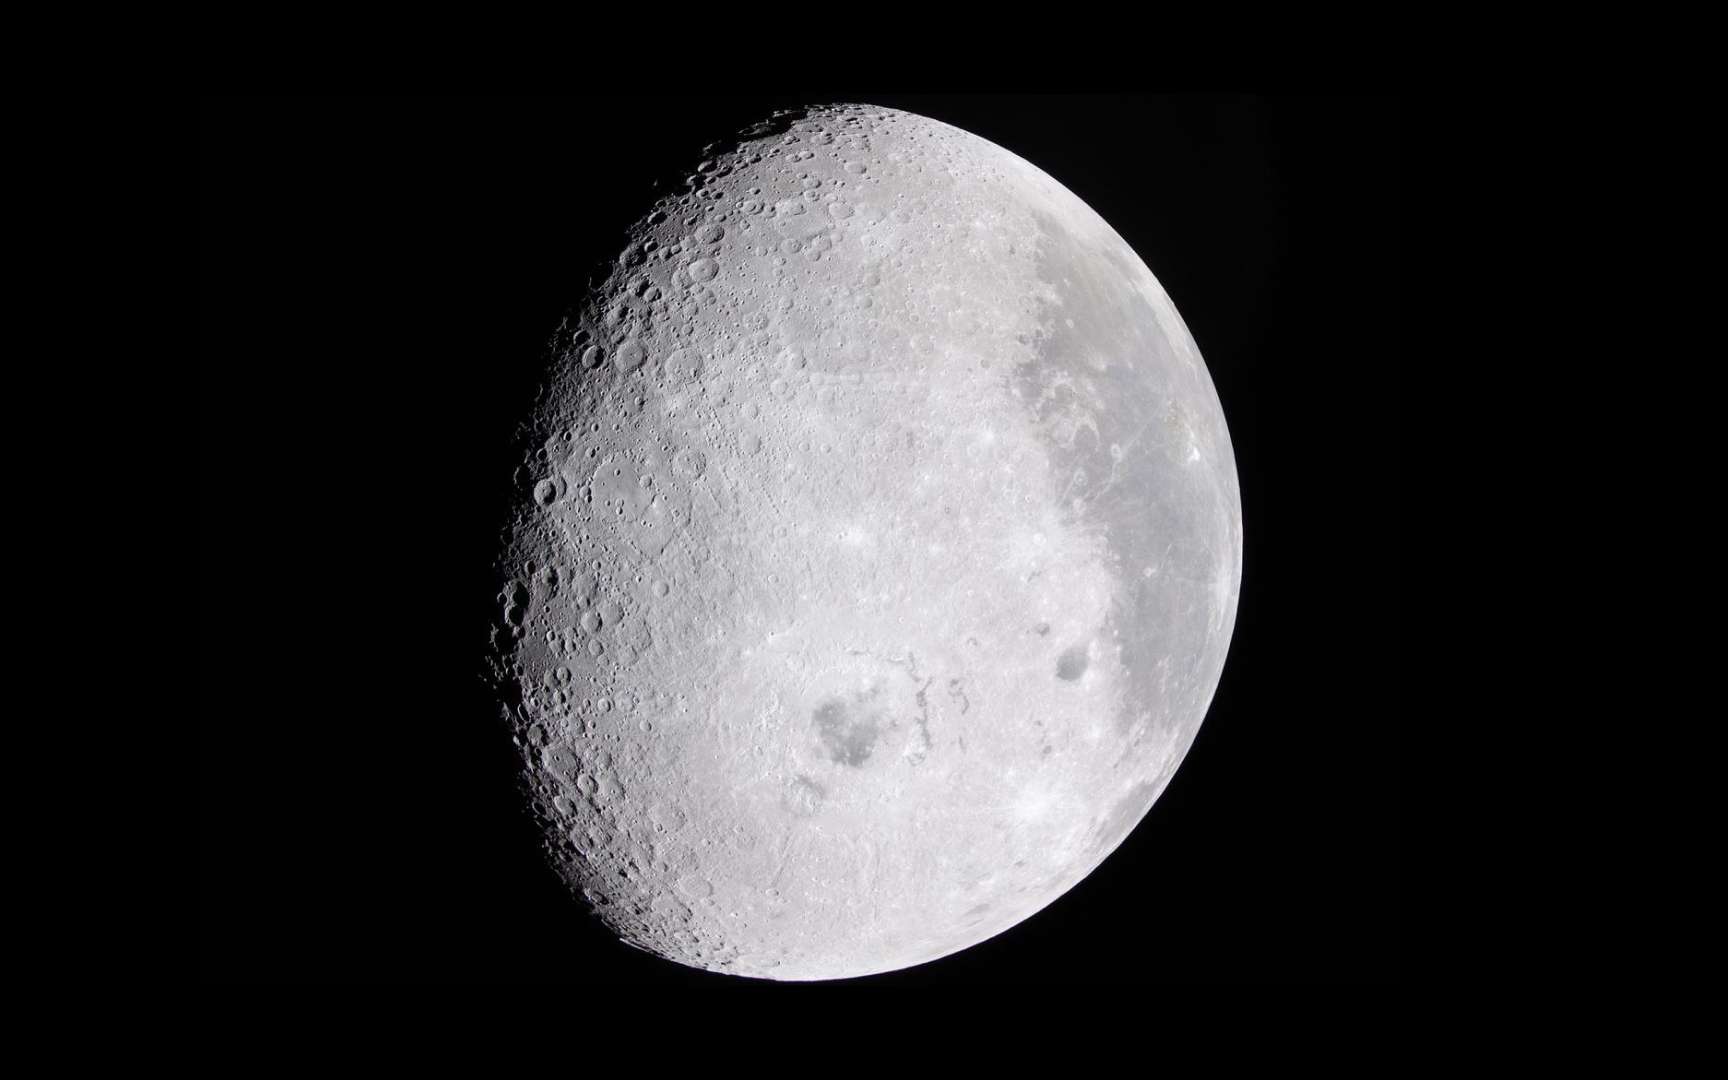
La Lune a été observée sous toutes les coutures depuis des décennies, mais ses données restent dispersées entre de nombreux instruments et missions. IBM et la Nasa viennent de rendre public un modèle d’intelligence artificielle conçu pour les faire dialoguer afin de mieux connaître le seul...
L'équipe derrière
suyu
, l'émulateur Nintendo Switch né des cendres de
yuzu
, a publié le début septembre une dernière version de son logiciel, puis a fermé le
dépôt
sur un ultime commit intitulé "FINAL". Et cette version d'adieu embarque un truc que j'ai trouvé intéressant. C'est un mode baptisé Recompiler, qui change totalement la façon dont le code du jeu est "traduit".
D'habitude, un émulateur traduit les instructions ARM de la console en instructions x86 au fur et à mesure que le jeu tourne. C'est ce qu'on appelle un JIT. Alors que là, le mode Recompiler fait le boulot à l'avance en prenant le code ARM64 du jeu et en le convertissant en code C.
Le
code de suyu
ne cache pas d'où vient l'idée, puisqu'il se décrit lui-même comme un moteur produisant du C portable "à la manière de N64Recomp". Grâce à cette technique de recompilation, en bout de la chaîne, vous obtenez un vrai binaire .exe sous Windows, ELF sous Linux, ou Mach-O sous macOS.
Faut savoir qu'un jeu entier, ça fait des millions de blocs de code (oui, des millions !), et réunis dans un seul fichier C, ça pèserait des centaines de mégaoctets. Soit de quoi occuper un compilateur durant des heures avec beaucoup de mémoire consommée et éventuellement un abandon par K-O technique ^^... Alors qu'en le recompilant, on peut profiter de perfs natives sans éclater la machine.
Maintenant la réalité c'est que le programme obtenu grâce à cette recompilation, ne se débrouille pas tout seul. Le JIT n'a pas vraiment disparu, mais se construit à la demande, dès que l'exécution tombe sur une adresse que l'analyse statique n'avait pas repérée (un appel indirect, typiquement). Sans ce filet de sécurité, le jeu se figerait sur un écran noir. Je vois bien comment ça marche parce que c'est ce que j'ai exploré avec mon outil de recompilation Kompote.
Et ensuite, le jeu recompilé continue de passer par la couche d'émulation de suyu pour ses services système et son GPU. Bref, on est encore loin du jeu Switch qui tournerait tout seul sur votre PC, mais je n'ai aucun doute sur le fait que ça arrivera bientôt.
Notez que les binaires téléchargeables datent tous du 4 septembre, alors que les derniers correctifs ont été committés les 12 et 13. Il faudra donc compiler le code pour profiter de cette dernière version.
Quant à savoir pourquoi le projet s'arrête maintenant, l'équipe n'en dit pas un mot mais je sais juste qu'un
avis DMCA de Nintendo
avait déjà emporté son dépôt principal en juillet 2024, et qu'un
nouvel avis du 17 août dernier
avait fait tomber d'un coup 307 dépôts dont l'adresse contenait le mot suyu.
Mais rassurez-vous, ça ne veut pas dire que l'émulation Switch s'arrête pour autant puisqu'un
fork
a repris le code dans la foulée et enchaîne déjà les versions.
Et
Eden
, le projet dont suyu descend directement, continue tranquillement sa route sur son propre serveur, loin de GitHub, avec une version publiée en juin et un dépôt encore actif à la mi-septembre. C'est donc là qu'il faut regarder si vous cherchez un émulateur Switch encore suivi.
Source : le dépôt archivé de suyu et l'article de
Wccftech
OpenDisplay
est un outil open source qui vous permet d'avoir un affichage déportée de macOS sur n'importe lequel de vos appareil Apple dont vous ne faites rien. Et ce n'est pas une recopie basique de votre bureau, mais bien un écran que macOS affichera dans ses réglages d'affichage, et sur lequel vous pourrez faire glisser vos fenêtres comme sur n'importe quel écran externe.
Alors oui, je saiiiis, Sidecar fait déjà ça, et gratuitement en plus, mais Apple s'est arrêté à l'iPad et les deux appareils (votre iPad + votre ordi) doivent être connectés avec le même compte Apple. Du coup, votre iPhone ou un vieux Mac qui ne sert plus, n'ont jamais été invité à la fête, et les appareils Apple de votre conjoint.e encore moins.
Pour faire fonctionner ça, une seconde application, OpenDisplay Receiver, s'installe dessus et le transforme ainsi en écran. Elle ne réclame que macOS 12 Monterey, ce qui permet à des Macs sortis à partir de 2015 environ de rester dans le game. Le Mac qui envoie l'image, lui, devra être sous macOS 14 minimum.
Côté installation, l'application iPhone et iPad est sur l'App Store, totalement gratuite, à partir d'iOS 16.4. Votre Mac principal, lui, récupère de son côté un DMG signé et notarisé par Apple (ça veut dire que ça s'ouvre au double-clic sans que Gatekeeper vienne râler et ça c'est cool).
Ensuite vous branchez le matos, et comme OpenDisplay passe par usbmuxd qui est un service déjà présent dans votre macOS, il n'y a pas d'outil tiers et pas de tunnel à monter, ça se connecte tout seul. Attention quand même au câble, car il doit transporter des données. Cela veut dire qu'un câble lambda de charge seule ne fonctionnera pas. Et une fois l'écran en place, l'appareil deviendra tactile pour le Mac, donc, vous pourrez faire défiler Korben.info avec vos deux doigts, like a boss !
Par contre, si vous souhaitez utiliser la connexion via le Wi-Fi, sachez qu'il y a un petit bug au niveau du curseur de la souris. Donc, en attendant que ce soit résolu, je vous invite vraiment à passer par le câble. Niveau sécurité, il y a un petit truc à savoir aussi : le flux vidéo qui circule sur le Wi-Fi se fait sans chiffrement.
Alors normalement, chez vous, ça ne devrait pas poser de problème, mais sur un réseau partagé ou public, je vous invite vraiment à brancher le câble USB. Parce que sinon, ça veut dire que n'importe qui pourrait récupérer votre flux d'écran en passant par la même borne Wi-Fi que vous. Un transport chiffré avec appairage des appareils est prévu, il n'est pas encore là.
Dernière chose à savoir avant de vous lancer : l'application Mac s'appuie sur CGVirtualDisplay, une API privée de CoreGraphics, la même que celle de
DeskPad dont je vous avais parlé
. C'est pour ça qu'elle n'est pas distribuée sur l'App Store, et malheureusement, une mise à jour de macOS peut très bien la casser.
Voilà, si vous avez un iPhone qui prend la poussière ou un vieux MacBook / iMac au fond d'un placard, c'est à tester !
Si vous avez une petite console rétro portable qui traîne, du genre une Miyoo Mini, une TrimUI Brick, une
Anbernic RG35XX
, vous avez sans doute remarqué que l'interface livrée avec fait le job mais sans plus. Ça tombe bien, spruceOS est là pour ça ! Et malgré son nom, ce n'est pas vraiment un système d'exploitation. En réalité, il s'agit d'un frontend codé en Python qui vient se poser sur une base système déjà existante. Le code est public, sous une licence Creative Commons donc pour les plus capitalistes d'entre vous, ça veut dire pas d'usage commercial sans permission écrite de l'équipe.
Sur les Miyoo et les TrimUI, la base en question est le système d'origine de la console, celui du fabricant. Sur les Anbernic à puce H700 et sur la Powkiddy RGB30, il faut d'abord installer une base tierce sur la première carte mémoire, genre BaseOS pour les Anbernic, dArkMoss pour la Powkiddy. La carte spruce, elle, ira dans le second emplacement, le TF2, et elle restera librement échangeable d'un appareil supporté à l'autre. Rien de dramatique donc, mais ça fait une étape de plus et une carte en plus.
Ce que vous y gagnez si vous installez spruceOS, c'est surtout du confort au quotidien. Vous maintenez le bouton HOME pendant trois secondes et le Game Switcher vous laisse sauter d'un état de sauvegarde à l'autre sans quitter votre partie. Quand vous éteignez la console en plein jeu, elle sauvegarde même toute seule son état et vous remet exactement là où vous en êtiez au rallumage. Et si votre console a le Wi-Fi, vous ne repassez plus par le PC pour l'habiller puisque l'outil Theme Garden pioche dans plus de quatre-vingts thèmes communautaires dispo en ligne, le Game Nursery télécharge des portages gratuits / homebrew, et un scraper récupère même les jaquettes des jeux depuis la base libretro.
Le menu principal de spruceOS, avec les quatre icônes du thème SPRUCE par défaut
Ce qu'il vous faut avant de commencer
Il vous faut une carte microSD neuve, d'une vraie marque, achetée chez un revendeur sérieux ainsi qu'un bon lecteur de cartes. Et bien sûr un ordinateur sous Windows, macOS ou Linux avec une connexion Internet.
Et surtout, n'utilisez pas la carte livrée avec la console. C'est pas moi qui le dit mais le wiki du projet qui est catégorique là-dessus, en majuscules dans le texte : "DO NOT USE THAT STOCK SD CARD!", parce qu'elle est mauvaise, que les jeux dessus sont mauvais et que les BIOS le sont aussi. Donc gardez-la dans un tiroir, elle vous servira pour revenir en arrière en cas de foirage.
L'installation en un clic
L'équipe a sorti un installeur tout-en-un, qu'elle présente comme entièrement open source, disponible pour Windows, Linux et macOS. Il formate la carte, télécharge la version que vous choisissez et l'installe, en une seule opération. Une seule précaution, et le projet la signale lui-même : vérifiez bien que le lecteur que vous désignez est votre carte, parce que l'installeur écrit sur celui que vous lui montrez. C'est le chemin recommandé, et c'est aussi lui qui règle le cas des Anbernic et de la Powkiddy : BaseOS et dArkMoss ont chacun leur onglet dans l'application et se téléchargent puis s'installent automatiquement, sans que vous ayez à aller chercher une image ailleurs.
Un détail qui coince sur Mac, et qui n'est écrit nulle part ailleurs que dans le dépôt : macOS interdit aux applications d'écrire sur un disque amovible sans permission explicite, et l'installeur passe par le Terminal. Il faut donc aller dans Réglages Système, Confidentialité et sécurité, Accès complet au disque, ajouter Terminal, puis quitter et rouvrir le Terminal. Ce dernier point compte, la permission ne s'applique pas à une session déjà ouverte.
Sur Mac, Terminal doit figurer dans Accès complet au disque pour que l'installeur puisse écrire sur la carte (
Source
)
L'installation à la main
Si vous préférez faire ça vous-même, il vous faut un utilitaire de formatage et 7zip. Vous formatez la carte en FAT32, avec Rufus sous Windows ou l'Utilitaire de disque sous macOS en choisissant MS-DOS (FAT32). Vous récupérez l'archive spruce.vX.X.X.7z sur la page des versions du dépôt, vous l'extrayez sur votre ordinateur, puis vous copiez le contenu extrait sur la carte. Vous éjectez proprement, vous insérez la carte dans la console et vous allumez.
Et là, attention au piège, puisque le paquet contient un dossier caché nommé .tmp_update, et sans lui spruce ne fonctionnera tout simplement pas. Donc affichez les fichiers cachés avant de les copier : sur Mac c'est Commande + Majuscule + point, et sur Ubuntu le dossier est masqué par défaut lui aussi. Sur Mac, pensez aussi à nettoyer les fichiers .dot parasites avant d'éjecter la carte. Un utilitaire comme
CleanEject
fait ça très bien.
Vos jeux et vos BIOS
Les ROMs se rangent ensuite dans un dossier Roms, avec un sous-dossier par machine. La plupart des noms sont évidents, mais certains noms piègent tout le monde comme SFC ou FC. Hé oui, les jeux Super Nintendo vont dans SFC, pour Super Famicom, et pas SNES ; les jeux NES vont dans FC, pour Famicom, et pas NES. Les vidéos et la musique, elles, vont toujours dans MEDIA.
Les BIOS se posent dans un dossier BIOS à la racine de la carte, mais il faut les placer dans le sous-dossier qui va bien par machine et pas tout balancer en vrac. Le BIOS de la Dreamcast veut son sous-dossier, certains sont obligatoires pour que la machine tourne, d'autres pas. Donc je vous invite à vous renseigner en fonction de la machine que vous voulez émuler. Et comme d'hab, le BIOS de la NeoGeo ne va pas dans BIOS mais avec les jeux.
BIOS/dc/dc_boot.bin Dreamcast, obligatoire
BIOS/gba_bios.bin Game Boy Advance, facultatif
Roms/NEOGEO/neogeo.zip NeoGeo, obligatoire, et pas dans BIOS
Et évidemment, le projet ne fournit ni ROMs commerciales ni BIOS et ne vous dira pas où les trouver, donc c'est à vous de voir avec vos propres cartouches et vos propres disques.
Si l'écran reste noir
Maintenant, si c'est tout noir au lancement, vérifiez que le dossier .tmp_update est bien présent sur la carte. Remettez-la dans l'ordinateur, réaffichez les fichiers cachés, et regardez : si vous avez copié sans avoir activé l'affichage, il n'y est pas. L'autre suspect, c'est la carte elle-même. C'est peut-être parce que vous avez acheté une no-name de merde.
Le moment où vous ne pourrez plus revenir en arrière
Tant que vous ne touchez qu'à la carte, vous ne risquez rien de définitif. Sur la famille Anbernic RG35XX, les guides de référence le disent tous : ces firmwares vivent entièrement sur la microSD, et donc on peut passer de l'un à l'autre sans modification permanente de l'appareil. Ailleurs le principe est le même, et pour retrouver votre console en version d'usine il suffit donc de remettre la carte d'origine.
Sauf qu'il y a UNE exception !! spruce embarque un Firmware Updater qui apparaît tout seul dans vos applications si votre console tourne sur un firmware ancien. Celui-là n'écrit pas sur la carte mais dans la mémoire interne de la machine, et le wiki prévient sans détour : "Failure to follow the firmware updating instructions can lead to a bricked device.". En gros si vous le lancez pour faire la mise à jour du firmware, ça peut bricker votre console, donc pensez bien à la brancher sur le courant avant la mise à jour. Le projet documente d'ailleurs deux procédures de débriquage, dont une qui demande carrément d'ouvrir la Miyoo Flip et de débrancher sa batterie, ce qui vous dit assez bien à quel point on a quitté le terrain du réversible...
Et si spruceOS ne vous convient pas, vous ne serez pas coincé pour autant car sur ce même matériel,
le guide de référence de Retro Game Corps
recommande aussi
Knulli
pour son interface EmulationStation, ou encore
muOS
pour la performance d'émulation la plus avancée, à condition que le bricolage de configs customs ne vous rebute pas. Après voilà, chaque "OS" a sa carte et vous changez d'avis quand vous voulez.
Un développeur espagnol, Emilio Cano Pérez, vient de publier le SDK de son CanoFlash, un petit boîtier monté sur un XIAO ESP32-S3 qui se branche sur le port Link d'une Game Boy Advance. Cela ne nécessite aucune modification de la console, ni de fer à souder (cool !), et une fois branché, ça permet à la console de récupérer la connexion Wi-Fi qu'elle n'a jamais eue !
Alors comment ça fonctionne ? Hé bien le truc démarre en mode Multiboot et pousse sa propre application dans la RAM de la console. Ensuite c'est lui qui se coltine la gestion de tout le réseau, pendant que la GBA se contente d'échanger avec lui des paquets de taille fixe. En clair, un jeu n'a pas à connaître l'existence du Wi-Fi. Il parle juste au boîtier à travers le SDK dispo sur GitHub, qui lui apporte le matchmaking public, les salons privés et des parties jusqu'à huit joueurs.
Sauf qu'avant de sortir votre Game Boy du tiroir, il faut lire
la FAQ du créateur
parce qu'il y écrit que le jeu en ligne fonctionnera uniquement dans les jeux qui intègrent son SDK, et qu'il ne transforme pas automatiquement le multijoueur Link des jeux existants en multijoueur Internet. Roooh, c'est dommage quand même. Ça veut donc dire que votre cartouche collante de Pokémon Rubis ne fonctionnera pas via le Wi-Fi... Pour jouer, il vous faudra donc des homebrews compilés avec le kit, plus un boîtier et une console par joueur.
Maintenant, si c'est vraiment vos vieilles cartouches que vous voulez faire jouer à distance, l'appareil qui fait ça, c'est le
GB-Link USB dont je vous ai parlé en juin
. Lui se fait passer pour un câble Link, se relie en USB-C à un ordinateur ou à un smartphone Android, et un client web différent parle le protocole de chaque jeu : les échanges Pokémon des trois premières générations, les parties d'Advance Wars. Dans le même genre,
ChisLink
est un projet à monter soi-même dont le relais transporte les paquets des jeux compatibles avec l'adaptateur sans fil de Nintendo.
Cette limite du CanoFlash n'est d'ailleurs pas une bizarrerie de conception, parce que l'adaptateur sans fil sorti par Nintendo en 2004, c'était exactement pareil. Il était fonctionnel avec seulement à 46 jeux compatibles, tous sortis entre 2004 et 2006. Ça ne remplaçait pas non plus le câble Link.
Du coup, le CanoFlash, son vrai métier, c'est surtout de vous permettre de parcourir vos homebrews et vos sauvegardes personnelles via Wi-Fi, de flasher le jeu de votre choix sur votre cartouche réinscriptible et de synchroniser les sauvegardes, le tout sans PC.
Par contre, cette cartouche réinscriptible compatible dont je vous parle, à base de S29GL256, elle est indispensable et elle n'est ni incluse ni vendue dans la campagne Kickstarter CanoFlash. Même chose pour la batterie, même si le boîtier accepte de tourner sur USB-C. Donc comptez le prix de la cartouche en plus avant de vous emballer, et sachez aussi que la campagne Kickstarter n'est toujours pas lancée à l'heure où j'écris ces lignes.
Le
SDK, lui, est déjà là
, et il se compile sans avoir le moindre boîtier sous la main. Bref, de quoi préparer votre jeu tranquillement en attendant que le matériel existe...
Vous voulez vérifier un truc dans une vieille version de Python, du genre celle de 2017, histoire de voir si le bug que vous traquez vient de là. Normalement ça veut dire chercher une image Docker ou un vieux binaire de python, pour faire vos tests. Mais avec trynix, vous cliquez un lien et hop, vous avez un shell avec votre outil.
Ce site est signé Farid Zakaria, qui bricole autour de Nix depuis des années et appelle ça son "magnum opus". En gros, une machine Linux x86_64 démarre dans votre onglet, avec le paquet demandé déjà accessible dans le PATH. Rien à installer et pas de compte à se créer, ça marche direct dans le browser.
J'ai essayé ce matin avec
python3 en version 3.6.2
. Le navigateur va chercher les chemins du store, vérifie leurs signatures, et au bout d'une trentaine de secondes le prompt s'affiche. Je tape alors python3 --version, il me répond Python 3.6.2, avec la glibc 2.25 et l'OpenSSL 1.0.2l de l'époque livré avec. Et voilà comment je me retrouve avec un Python de 2017 dans un Chrome de 2026, sans rien toucher à ma machine.
Le terminal de la machine virtuelle, dans l'onglet : Python 3.6.2 répond, et les seize chemins du store sont vérifiés juste au-dessus.
Et ce ne sont pas trois démos préparées à l'avance puisque l'index recense les 310 000 et quelques versions que nixpkgs a livrées en treize ans. Toutes ne démarrent pas, attention, il n'y en a que 274 729 avec un binaire x86_64 dans le cache, et le reste est non libre, cassé, ou hors du lot.
Ce qui rend la chose possible, c'est en fait une simple ligne d'en-tête HTTP. Le cache binaire de Nix sert un access-control-allow-origin: *, donc votre navigateur a le droit d'aller y piocher tout seul. Et le plus drôle, c'est que Zakaria avait lui-même réclamé cet en-tête en 2021, pour un tout autre projet. Et 5 ans plus tard, il s'en sert pour démarrer des machines virtuelles... Qui aurait pu prédire comme dirait l'autre !
Pour l'émulation, après il n'a rien réinventé. Il a tout simplement repris prend
qemu-wasm
, le QEMU compilé en WebAssembly de ktock, et la machine virtuelle ne boote même pas vraiment, mais reprend un instantané figé à l'avance. En tout cas, c'est bien pensé et très pratique.
Du Linux dans un navigateur, je vous avais d'ailleurs déjà montré ça ici avec
cette machine virtuelle x86
. Sauf que ces trucs-là chargent une image figée à l'avance, alors qu'ici, on choisit vraiment son contenu en 1 clic.
Niveau vitesse, le projet annonce un lancement en 3 secondes, mais c'est le temps d'obtenir le shell quand tout est déjà dans le cache du navigateur. Chez moi, lors de mes tests, au premier passage, il a fallu 30 secondes, puis 7,5 secondes au suivant. Et une fois dedans ça reste poussif, parce que chaque binaire est traduit du x86 vers le WebAssembly à son premier lancement, ce qui peut faire monter le chargement à deux minutes sur les gros binaires.
Et il y a aussi un plafond puisque tout doit tenir dans la mémoire de l'onglet, soit environ 1,5 Go. Et c'est une console série, donc vous ne pourrez rien lancer de graphique, pas de fenêtre, pas de souris... Bref, que les outils en ligne de commande et rien d'autre ! Mais bon, vous êtes de vrais barbus qui n'ont peur de rien à part du déo, donc je ne suis pas inquiet ^^.
Ce qui est vraiment cool avec Trynix surtout, c'est
l'action GitHub que son dev a sortie
dans la foulée. Si votre intégration continue pousse déjà ses compilations dans un cache, un bot colle un lien sous la pull request et le relecteur lance le code au lieu de le lire. Comme ça, fini le clone, la compilation et le "*ça marche chez moi pourtant *" invérifiable. Même topo pour faire essayer un truc à quelqu'un qui n'a ni Nix ni Docker... Suffit de lui envoyer le lien.
Un petit point sécu quand même que je tiens à vous signaler : L'URL transporte à la fois les caches supplémentaires et les clés qui les valident, du coup la signature vous prouve bien que le binaire vient du cache annoncé... mais pas qu'il vient de quelqu'un de fiable. En effet, cliquer sur un lien trynix inconnu, ça revient à lancer le programme d'un inconnu, et même si ça se passe dans la sandbox de l'onglet du navigateur (ce qui limite les dégâts), c'est quand même mieux d'en avoir conscience !
Bref, voilà encore un chouette projet sous licence MIT et si ça vous chauffe, ça se passe sur
trynix.dev
.
Restic
chiffre bien vos sauvegardes, rclone sait parler à 70 services de stockage, mais connecter les deux ensemble demande d'écrire des scripts et surtout de les surveiller. Eh bien bonne nouvelle, Pluton est l'interface web qui fait ce travail à votre place.
Vous y décrivez un plan de sauvegarde via un formulaire, avec une source, une destination, une fréquence, une politique de rétention, et Pluton fabrique les commandes restic derrière. Les sauvegardes restent ainsi incrémentielles et chiffrées avant l'envoi. La destination peut être un disque local, un bucket S3, un Backblaze B2 ou un Google Drive, et le même plan peut se répliquer vers plusieurs stockages pour respecter la fameuse règle 3-2-1.
L'installer
Je vous ai préparé un petit kit IA pour ceux qui ne jurent que par leur agent :
Un dossier, deux fichiers, et c'est parti. Le docker-compose.yml d'abord, dans lequel vous montez ce que vous voulez sauvegarder en lecture seule et le dossier qui recevra les sauvegardes en écriture. Si vous êtes sur Mac, lisez l'avertissement plus bas avant de monter quoi que ce soit, car ce montage-là m'a joué un tour :
Par contre, attention à cette ENCRYPTION_KEY, c'est le point à ne pas rater. Le compose officiel la documente comme la clé de chiffrement des snapshots restic et rclone, et c'est bien ça. Il s'agit du mot de passe de vos dépôts, c'est la même clé pour tous vos plans. Et donc la perdre, c'est perdre vos sauvegardes, et la changer rendra illisible tout ce qui a déjà été écrit. Bref, copiez-la dans votre gestionnaire de mots de passe avant d'aller plus loin, parce que le jour où vous en aurez besoin, personne ne pourra vous la redonner.
Puis faites un :
docker compose up -d
L'interface répond alors sur le port 5173 et vous demande directement les identifiants du .env. Pas d'assistant de première configuration, pas de compte à créer... en fait quand les variables sont bien configurées, Pluton s'installe tout seul au démarrage. Chez moi, entre le up -d et l'écran de connexion, il s'est donc passé moins d'une minute.
Créer le premier plan de backup
Le bouton "+ New" de l'interface ouvre un assistant en quatre écrans. Vous nommez le plan, vous gardez la stratégie "Incremental Backup" (les trois autres sont grisées, elles appartiennent à l'offre Pro), vous pointez /mnt/documents comme source et /mnt/backups comme destination, puis vous réglez la fréquence et la rétention. Le dernier écran laisse le chiffrement et la compression activés et propose de lancer la sauvegarde tout de suite, ce que j'ai fait.
Chez moi, trois fichiers de test de quelques octets sont partis en quelques secondes. Et c'est là qu'il faut regarder la bonne chose pour vérifier que ça fonctionne... Non, c'est pas la pastille verte, mais plutôt le nombre de fichiers et leur taille.
Le plan Documents juste après sa première sauvegarde.
En fait, si je vous dis ça, c'est parce que sur mon Mac, avec Docker Desktop, restic n'arrivait pas à lire les dossiers montés depuis l'hôte, et sort en erreur d'entrée/sortie sur chaque fichier. Et pourtant, Pluton affichait quand même la sauvegarde en vert avec le statut "Complete". Les colonnes disaient bien 0 fichier et 0 octet, mais le statut, lui, semblait correct... Donc si vous êtes sur Mac, prenez plutôt l'installeur de bureau, qui existe aussi pour Windows et Linux, et dans tous les cas vérifiez que les chiffres sont OK après votre première sauvegarde.
Vérifier et répéter une restauration
Votre dossier de destination contient maintenant un config, un data/, un index/, un keys/ et un snapshots/, tous illisibles en clair. C'est un dépôt restic standard, et ça se vérifie sans Pluton, avec le binaire embarqué dans le conteneur :
Vous obtenez la liste de vos snapshots avec leur taille, et avec une mauvaise clé, restic répondra "wrong password or no key found" et s'arrêtera là. Faites les deux essais car ça prouve en une fois que le chiffrement travaille, et que vos données restent récupérables même si Pluton disparaît demain.
Le menu d'une sauvegarde propose ensuite "Browse", qui ouvre le snapshot comme un explorateur de fichiers, avec la taille de chacun et un bouton pour le télécharger ou le restaurer seul.
Le contenu du snapshot, fichier par fichier, avec le téléchargement et la restauration à droite de chaque ligne
Et le "Restore" lancera un assistant qui vaut le détour puisqu'il sait restaurer vers un chemin différent de l'original. Il vous laisse choisir quoi faire des fichiers déjà présents, et surtout il génère un aperçu en dry run (à blanc quoi...) avant de toucher au disque. J'ai restauré mes trois fichiers vers un dossier séparé, puis comparé avec les originaux, et c'était identique. Faites-le une fois, tranquillement, pendant que vous n'en avez pas besoin.
Voilà, tout ça, c'est la version gratuite, pour la machine où elle tourne. Maintenant, si vous voulez piloter les sauvegardes de plusieurs machines depuis la même interface, ça passera par l'offre Pro à 59 dollars par an. Si vous voulez comparer avec un autre truc, sachez aussi que
Zerobyte
joue dans la même cour.
Le développeur Mayuki Sawatari vient de publier
ReProgman
, un clone du Program Manager de Windows 3.1.
Ça ne vous dit rien ? C'est parce que vous êtes des bébés !
En fait, progman.exe, c'est ce truc qui servait d'interface principale à Windows avant que le menu Démarrer ne débarque avec Windows 95. Et aujourd'hui, grâce au taf de Sawatari, ça tourne aussi bien sur Windows 11 que sur macOS.
Pour ceux qui ont commencé l'informatique après 1995, faut savoir qu'avant ça, on n'avait pas de bureau, pas de barre des tâches, mais juste une grande fenêtre grise remplie de sous-fenêtres, et dans chaque sous-fenêtre y'avait des icônes de programmes alignées sur une grille. Vous double-cliquiez sur l'une d'elles, le programme se lançait, et voilà, vous aviez fait le tour de Windows !
Le groupe Main ouvert sur Windows 11, et la rangée de groupes réduits en bas de la fenêtre
Regardez bien les icônes sur cette capture : Docker, Edge et Claude rangés dans une ambiance de 1992...
Car ReProgman ne se contente pas de reproduire la déco. Au premier lancement, il scanne votre menu Démarrer (ou vos dossiers Applications si vous êtes sur Mac), transforme chaque dossier en groupe et range le tout dans son propre fichier Groups.ini. Après ça, il n'y retourne plus tout seul, et ce que vous déplacez, renommez ou supprimez dedans ne redescend jamais vers vos vrais raccourcis. Un menu permet quand même de relancer l'import à la main, et il n'ajoute alors que ce qui manque.
Du coup, vous récupérez les gestes de l'époque pour de vrai. Vous attrapez une icône, vous la lâchez dans une autre fenêtre et elle déménage, avec Ctrl enfoncé elle se copie, le menu Window vous range tout ça en cascade ou en mosaïque, et les fenêtres réduites redeviennent des icônes alignées en bas de la fenêtre principale. Même la boîte de dialogue de sortie a été refaite, à ceci près qu'elle annonce la fin de votre session ReProgman et non celle de Windows.
Maintenant, d'où ça sort comme délire ?
Hé bien, l'auteur raconte, dans un message relayé par Tom's Hardware, qu'il a simplement demandé à Claude de lui fabriquer ce clone, et que la première version obtenue en une heure était déjà plutôt correcte, même s'il a ensuite fallu rattraper les imperfections.
Ce qui est intéressant, c'est que dans son dépôt git, on trouve un document de spécification de plusieurs centaines de lignes qui décrit l'interface au pixel près, relevée sur des captures 640x480 du Windows original. Le cadre d'une fenêtre y fait 1 pixel noir, 2 pixels gris et encore 1 pixel noir, et la petite barre du menu système mesure 13 pixels sur la fenêtre principale contre 7 sur une fenêtre enfant. C'est d'ailleurs comme ça qu'on les distinguait à l'époque.... Fallait avoir l'oeil !
Si vous voulez l'essayer, ça se présente sous la forme d'un binaire autonome. Par contre sur Mac, la version distribuée n'est pas notarisée, il faudra donc lui passer un xattr -cr ReProgman.app ou utiliser
Sentinel
avant qu'elle accepte de démarrer. Ah et le code est sous licence MIT.
Le périmètre annoncé par le projet est d'ailleurs plus étroit qu'il en a l'air, puisque c'est Windows 11 en x64 et en Arm, et macOS uniquement sur Apple Silicon. Donc si vous êtes resté sur Windows 10 parce que vous aimez le risque ou sur un Mac Intel parce que vous aimez prendre votre temps, il n'y a rien pour vous amuser... Il faudra alors retourner du côté de
ce musée de vieux systèmes d'exploitation
que je vous avais montré, qui lui passe par l'émulation.
Après, je pense pas que vous y ferez votre vie mais ça vous donnera environ 30 secondes de nostalgie avant de refermer la fenêtre. C'est déjà ça de pris...
Une vidéo postée sur X montre Super Mario 64 qui tourne sur une machine ARM, sous un système qui n'est ni Windows ni Linux. Oui, c'est bien ReactOS, le clone libre de Windows, et le jeu est un exécutable x64 tout ce qu'il y a de plus banal !
Et n'allez pas croire que c'est un émulateur qu'on aurait posé sur un OS libre. Que nenni ! Pour exécuter du x64 sur de l'ARM, il faut deux trucs qui n'ont rien à voir l'un avec l'autre : un moteur qui traduit les instructions du processeur, et un système capable de faire cohabiter du code natif et du code traduit dans un même programme.
La première moitié, c'est FEX,
l'émulateur financé par Valve
dont je vous parlais en décembre. Sauf que côté Windows, FEX se limite au processeur :
sa propre documentation
précise que la traduction des appels système revient soit à Wine, soit à l'ABI du système. Tout le reste est alors à la charge de l'hôte.
Cette seconde moitié porte un nom, ARM64EC, et c'est une
invention de Microsoft
pour Windows 11 sur ARM (oui, la boîte que ReactOS passe justement son temps à recopier). Le principe consiste à compiler les bibliothèques du système en ARM64 avec une interface appelable depuis du code x64 recompilé. Du coup, un même programme mélange des morceaux natifs et des morceaux émulés, et seul ce qui doit vraiment l'être passe par l'émulateur. L'intérêt de faire comme ça, c'est surtout la vitesse !
Jusqu'ici, deux entités avaient bâti cet "étage" : Microsoft dans Windows, et
Wine depuis sa version 10
. ReactOS est donc la troisième. Son développeur Ahmed Arif a ainsi écrit son propre runtime hybride dans le ntdll du système, avec le chargeur d'images, les ponts qui rendent les fonctions natives appelables en x64, et le déroulement de pile.
Ensuite, pour vérifier que tout se tient, il fait tourner le même binaire des deux côtés, sur son ReactOS et sur un vrai Windows 11 ARM64, puis il compare.
Screenshot
Alors, est-ce que vous pouvez l'installer ?
Et bien malheureusement, non !
Tout ce boulot n'existe que dans une branche d'un fork personnel, et le dépôt officiel de ReactOS n'en contient pas la moindre ligne. Et c'est mieux pour l'instant car, comme Ahmed le dit lui-même, son fork est encore plus expérimental que ReactOS lui-même ! C'est donc à réserver aux machines virtuelles, aux cartes de développement ou aux bécanes sans données sensibles. Bref, venant d'un projet qui se présente déjà lui-même comme un système de qualité alpha, ça vous situe l'ambiance...
Si comme moi, vous êtes un jeune entrepreneur plein de talent, vous avez sûrement déjà signé des tas de contrats, de NDA et autres documents relatifs à votre société. Et pour cela, en général, nos interlocuteurs et autres avocats ne se font pas chier : ils nous envoient des liens vers des plateformes comme Yousign ou DocuSign,
Car oui, faire signer un contrat à trois personnes passe en général par un service en ligne qui compte le nombre de documents et facture au volume. Snif... Mais c'était sans compter sur le
projet DocuSeal
qui fait exactement le même travail depuis un conteneur Docker tout simplement posé sur votre serveur. C'est l'avantage d'avoir une solution open source, et surtout, ça permet de tout garder chez vous et de ne rien envoyer sur des serveurs tiers.
Vous chargez un PDF, vous posez les champs à la souris dans un éditeur visuel, et vous envoyez ça à vos interlocuteurs. Il y a 10 types de champs côté version libre, notamment case à cocher, image, date et sélection multiple. Plusieurs signataires se succèdent ensuite dans l'ordre que vous fixez, chacun ne recevant le document qu'une fois que le précédent est passé, et les invitations partent via votre propre serveur SMTP.
Les documents signés restent ensuite sur le disque de la machine, à moins que vous ne préfériez les envoyer vers votre S3, votre Google Storage ou votre Azure.
L'API REST et les webhooks sont également dispo dans la version open source, Mais attention, toutes les fonctionnalités proposées par la version SaaS qu'il propose en mode payant ne se retrouvent pas forcément dans la version open source. Par exemple, on n'a pas la possibilité de créer des modèles différents pour générer des documents sur mesure par client.
Et là où l'auto-hébergement se paie vraiment, c'est sur le certificat car le cloud de DocuSeal signe avec un certificat reconnu par Adobe, alors que votre instance génère le sien par défaut. Donc, il faudra faire avec, surtout que le nombre de documents gérables est limité. Ou alors, modifiez vous-même le code source pour vous faire votre propre version custom.
Pour l'installer avec Docker afin de tester, c'est simple :
sudo docker run --name docuseal -p 3000:3000 -v.:/data docuseal/docuseal
Côté juridique, ce que vous récupérez est une signature électronique simple au sens du règlement eIDAS. C'est le niveau d'entrée, parfaitement valable pour un devis ou un accord interne. Par contre, ça ne supporte pas la signature qualifiée, qui est la seule à valoir juridiquement une signature manuscrite dans toute l'Union européenne.
Ce n'est d'ailleurs pas une faiblesse de l'open source car chez DocuSign aussi, la signature qualifiée se vend
en module complémentaire
des forfaits classiques. Chez DocuSeal, elle passe par un prestataire de confiance partenaire et se facture aujourd'hui 2 à 4 dollars pièce. Ensuite, le logo maison, le SSO, les relances et l'envoi en masse demanderont la licence Pro. Si vous choisissez de passer par leur version payante, faites attention à bien vous mettre sur l'instance européenne pour que vos documents soient conformes au RGPD et ne partent pas dans les mains des Américains.
Par exemple, comme je vous disais, le code est sous AGPL. Donc, vous pouvez faire un peu ce que vous voulez dedans tant que vous gardez l'attribution DocuSeal dans l'interface.
Et si vous n'avez pas le temps et que ça vous saoule d'auto-héberger votre propre, certificateur de documents, il existe aussi
Goodflag Community
, un service gratuit pour les particuliers, indépendants et associations dont vous n'êtes pas le produit (lol), qui vous permettra de faire tout pareil sans débourser un centime et avec de la signature qualifiée (Merci à Karefil pour l'info).
Vous avez un dossier plein d'enregistrements de réunions, d'entretiens ou de notes vocales que vous avez dictées en marchant, et vous ne les avez jamais réécoutés. Forcément, réécouter doit se faire en temps réel, et un fichier baptisé REC_20260812_143301.m4a ne permet pas forcement de savoir de quoi ça cause... Alors que faire ?
Hé bien
le projet Speakr
s'attaque exactement à ce problème. Vous y déposez vos fichiers, ou vous enregistrez directement depuis le navigateur en captant le micro, le son du système, ou les deux mélangés. Et en sortie, vous récupérez un texte en clair, cherchable, découpé par intervenant, avec un résumé et les actions à retenir.
Et si vous cliquez sur une ligne du texte transcrit, la lecture se lancera à cet instant précis. Mais Speakr va encore plus loin grâce à sa fonctionnalité Inquire. Grâce à ça, plus besoin de farfouiller dans un enregistrement. Vous posez simplement une question à toute la bibliothèque d'un coup du genre "qu'est-ce qu'on avait décidé sur le tarif, et qui n'était pas d'accord ?".
Un mode agent optionnel, encore en bêta, va même lire les enregistrements concernés un par un avant de répondre, avec des liens numérotés qui ouvrent chaque extrait à la seconde citée. Et chacun décide si ses résumés et ses notes privées sont lisibles par cet agent.
Reste la question qui fâche, parce que le projet se vend comme un truc auto-hébergé, donc privé. Et en creusant un peu, je me suis rendu compte qu'il y avait quand même des choses qui sortaient de la machine. Il y a d'abord la transcription, qui envoie l'audio au moteur qui le transforme en texte. Et celui du texte ensuite, qui expédie la transcription au modèle qui écrit les résumés, les titres et les réponses du chat.
Et dans la configuration de base, les deux usages IA pointent chez un tiers : une clé OpenAI pour l'audio, une clé OpenAI (ou OpenRouter) pour le texte. Votre serveur, lui, ne stockera que des fichiers...
Alors, il faudra bien penser, si vous voulez que ça reste en local, à brancher Ollama à la place d'OpenAI et OpenRouter. Mais couper celui de l'audio se paiera car pour réussir à transcrire de l'audio, il vous faudra quand même une bonne carte graphique et un gros modèle Whisper comme expliqué dans le
guide d'installation
.
Sans carte, ça tourne quand même, rassure-vous, mais ce sera plus lent.
Pour le reste, c'est du Docker avec SQLite ou PostgreSQL, 2 Go de RAM annoncés pour l'application seule, et tout ce qu'on attend d'un truc qui s'utilise à plusieurs : comptes, authentification unique, partages, API et webhooks signés.
C'est sous licence AGPLv3, doublée d'une licence commerciale pour ceux qui ne veulent pas s'y contraindre.
Niveau outils semblables, il y a
Scriberr, dont je vous ai déjà parlé
, transcrit en local sans jamais rien envoyer dehors, mais son auteur vient d'
annoncer une pause dans le développement
. On a aussi
l'application Meetily
, qui elle, vise le poste de travail plutôt que le serveur d'équipe, et réserve la séparation des voix à son offre payante. Et si c'est de la dictée en direct sur Mac dont vous avez besoin plutôt que d'exploiter des enregistrements déjà faits, j'ai codé
Kassis
pour ça, qui reste en local lui aussi.
Alors finalement, pourquoi ne pas donner sa chance à Speakr ?
Attention au « faux » libre, c’est-à-dire du gratuit trop dépendant d’une entité.
Yves Billon l’avait fait remarquer à la commission d’enquête parlementaire sur les dépendances numériques lorsque celle-ci menait, au printemps, ses auditions. « Cela concerne plusieurs sociétés, avait assuré le chef du service du numérique au secrétariat général des ministères économiques. Mais l’une, en particulier, dont le logo représente un chapeau rouge, nous pose des difficultés », avait-il ajouté…
Risque de centralisation
Matthieu Weill, intervenu lors de la même audition, lui avait en quelque sorte fait écho. « Nous avons de multiples exemples de solutions libres dont le cœur de l’équipe éditrice dépend en fait d’une société », avait expliqué le directeur de la transformation numérique au ministère de l’Intérieur. De là naît un risque : « Au début, le modèle économique de la société éditrice repose sur un logiciel libre avant qu’un nouvel investisseur n’arrive et que la stratégie change : la version libre est alors réduite à peau de chagrin, les maintiens en conditions opérationnelles et de sécurité ou les fonctionnalités de grande valeur que l’on utilisait deviennent payantes ».
Il faut, plus globalement, appliquer au logiciel libre le même type d’analyse et de réflexion que pour les solutions privées, affirme Matthieu Weill. En particulier, donc, avoir une « vision de long terme qui englobe le MCO et le MCS ».
À ce sujet, l’intéressé ajoute : « De même qu’un fournisseur peut faire faillite, un commun numérique qui n’est pas suivi dans la durée peut créer un problème de dépendance que l’on devra résoudre dans l’urgence ».
Ne pas trop miser sur les communs numériques ?
Auditionné ultérieurement, Alain Garnier s’est montré circonspect quant aux communs numériques. Ils sont certes un levier d’accélération de la capacité industrielle, a reconnu le président de Jamespot. Mais ils « ne rendent pas un industriel capable de packager un produit, d’innover et d’assurer un support ». Surtout, ils procurent aux GAFAM une matière première pour leurs IA et leurs systèmes. Alain Garnier y voit un « risque que nous courons pour les dix prochaines années » : celui de financer, par nos impôts, les briques que les Big Tech exploiteraient à leur profit « avant de nous les revendre avec le marketing, le support et l’intégration adéquats ».
Mélanie Dulong de Rosnay, directrice de recherche au CNRS, va dans le même sens. Les licences libres et ouvertes favorisent la diffusion, mais « autorisent l’extraction de la valeur sans réciprocité ni soutien à la création ou à l’infrastructure, alors que les communs numériques sont produits grâce à des financements publics ou au travail bénévole de communautés ».
Penser relations communautaires
Le déploiement d’outils libres nécessite aussi d’intégrer les ruptures technologiques, telle celle qu’a introduite Office 365, a rappelé Yves Billon. « On peut faire de la bureautique avec LibreOffice, mais on ne bénéficie pas de l’expérience utilisateur d’Office 365, de l’expérience cloud. Il a fallu reconstruire beaucoup de choses derrière. On y a beaucoup perdu sur le plan fonctionnel. Les utilisateurs l’ont ressenti. »
Les logiciels libres nécessitent, plys globalement, des ajustements avant leur installation dans de grandes organisations. Yves Billon mentionne le cas de la DGFiP. Non dépendante de Microsoft, elle s’était vu enjoindre d’opérer une structuration plus profonde de son SI au moyen d’un équivalent à Active Directory. La solution, Samba, n’était pas en mesure de gérer la complexité de l’organisation. On a donc dégagé des moyens pour l’adapter. « Nous nous sommes efforcés de mutualiser l’action à l’échelon interministériel. Nous avons perdu un an à un an et demi dans les négociations budgétaires pour trouver un accord. »
La démarche illustre ce qu’Yves considère comme une nécessité globale : savoir travailler avec les communautés. « Il importe qu’au sein des DSI, un certain nombre de personnes soient connues des communautés ou, au mieux, soient référentes au sein de celles-ci. »
Tenir compte de l’existant
Chez Tomasz Blanc, même son de cloche au sujet des ruptures technologiques. Le libre « offre parfois une ergonomie ou des fonctions collaboratives moins abouties » que des solutions commerciales, déclare le chef du service des SI de la DGFiP. Il impose aussi une discipline technique « pour ne pas s’égarer dans un écosystème trop foisonnant ».
« Il y a aussi des préalables techniques à valider, reconnaît l’intéressé, en écho à ses collègues. Sur un parc de 110 000 à 115 000 postes de travail, le défi, c’est l’administration de la flotte. Il faut pouvoir diffuser rapidement des correctifs de sécurité et déployer des logiciels à distance sans intervention physique. [Notre] environnement Windows bénéficie d’une automatisation très poussée. Nous devons nous assurer de disposer d’outils équivalents. »
Il faut aussi tenir compte de l’existant. À la DGFiP, il y a notamment encore des serveurs IBM Z qui supportent les applications historiques de calcul de l’impôt ou d’échanges bancaires. « Fiables et performants », ils sont coûteux (4,5 M€). Et en sortir est complexe : « La migration d’applications cobol vers des logiciels libres exige des projets longs et des tests rigoureux, comme l’illustre la refonte progressive de la paye des fonctionnaires d’État. »
La question de la maintenance
Dans le même esprit qu’Yves Billon, Thomas Jan, DGA en charge de l’innovation et de la stratégie numérique de l’UniHa (Union des hôpitaux pour les achats), souligne les questions d’interconnexion et d’interopérabilité que soulève le déploiement de logiciels libres.
Baptiste Grigy n’en dit pas moins, quoique dans un registre plus spécifique. « Nous essayons d’aller vers l’open source là où c’est possible, mais [ça ne l’est pas] partout. […] Microsoft, par exemple, est très profondément ancré dans nos SI, au-delà de ce que l’on voit comme l’OS et la suite Office : il pilote aussi la gestion de nos identités avec Active Directory ou la gestion de nos parcs de PC et de serveurs. »
Le DSI du CEA mentionne lui aussi le risque d’évolution des politiques tarifaires (« Au départ, c’est gratuit, puis, à mesure que l’usage augmente, que vous voulez mettre plus de données ou utiliser certaines fonctionnalités, cela devient payant »). Il élargit son propos : l’open source « présente une difficulté de mise à jour et nécessite des ressources internes importantes ».
Damien Roussetexprime le même sentiment. « L’open source a ses limites, notamment en termes de ressources humaines pour la maintenance, que nous n’avons pas toujours », déplore le directeur général délégué à l’administration de l’Inserm. « Avec les solutions propriétaires, nous recevons des paquets de mises à jour sur lesquels il suffit de cliquer pour les déployer, ajoute-t-il. Les outils open source […] demandent plus d’efforts : il faut […] parfois ‘ouvrir le capot’ ».
Des angles morts, comme en cyber
Dans ce contexte, l’Inserm ne perçoit pas toujours de débouchés open source pour remplacer ses outils propriétaires. Notamment dans la cyber. Son DSI Sammy Sahnouneconfirme : « Nous avons évoqué les ressources humaines nécessaires pour administrer des solutions open source. J’en ai plusieurs en tête pour lesquelles il faudrait une armée derrière, car l’administration se fait presque en ligne de commande. C’est possible pour un administrateur compétent. Mais au-delà de cela, je dirais que c’est la conception même des outils américains qui est extrêmement ergonomique et facilitatrice. »
Les options open source en matière d’outils spécialisés en cybersécurité « sont souvent limitées », confirmeVincent Strubel, directeur général de l’ANSSI.
Le catalogue de ressources ouvertes dans le domaine de l’IA est plus foisonnant. Mais il est « à la fois une réponse et une vulnérabilité », avertitDominique Luzeaux, général de division, chargé de mission « transformation numérique » auprès du commandant suprême allié pour la transformation de l’OTAN. « Lorsque des services de très bas niveau, téléchargés par de très nombreux développeurs sont programmés par une toute petite communauté d’informaticiens russes employés par l’entreprise Yandex, la question de la vulnérabilité se pose de façon aiguë. Or, tous les utilisateurs ne sont pas capables de vérifier l’intégralité des codes proposés. Et le très grand nombre de communautés qui existent, notamment sur GitHub, ne permet pas d’effectuer une revue exhaustive desdits codes. »
Le 24 août dernier, X Corp. a envoyé une lettre de mise en demeure au développeur de Nitter et une autre à celui de XCancel (une instance célèbre de Nitter). Le délai accordé était très court (environ 24h), et depuis, les deux services sont hors ligne.
Alors que s'est-il passé ?
Nitter, c'était sept ans de travail bénévole pour lire les posts publics de Twitter puis de X sans avoir besoin de compte, sans pub, sans JavaScript et surtout sans laisser son adresse IP à Elon Musk et ses sbires. On remplaçait x.com par nitter.net dans l'URL, et on lisait ce qui nous intéressait. Y'avait même des
extensions de redirection automatique
qui le faisaient pas à notre place. Et XCancel qui venait de fêter ses 2 ans, c'était tout pareil !
Aujourd'hui la page d'accueil de XCancel affiche ces 4 lignes qui disent en gros que le service est arrêté jusqu'à nouvel ordre. Celle de Nitter n'est pas plus bavarde et son mainteneur, zedeus, cherche un avocat et refuse de commenter.
Notez qu'aucun tribunal n'a été saisi et qu'une simple lettre a suffi.
Ce que X reproche à ces 2 services, c'est un "usage illicite et un contournement de son API", plus une violation du Texas Harmful Access by Computer Act et du Lanham Act.
TechCrunch, qui a pu lire le courrier
, rapporte une accusation plus précise qui est que Nitter aurait accédé à des comptes X et à des jetons de session pour récupérer le contenu en douce.
Aux États-Unis, en tout cas, "aspirer" des pages web publiques n'a rien de criminel. Mais le problème, c'est que Nitter ne fonctionne plus comme ça depuis des années. Si on analyse son code, on se rend compte que depuis que Twitter a supprimé les comptes invités début 2024, Zedeus, le développeur de Nitter, a mis en place un tout autre système.
Pour contourner les limites imposées par X.com, il a développé un script
tools/get_session.py
qui prend en arguments un identifiant X, un mot de passe, un secret à double facteur et un chemin de fichier.
Et là-dedans, il embarque en dur une paire de clés API, se déclare auprès des serveurs de X comme LE client Twitter officiel pour Android en version 10.21 tournant sur un OnePlus A3010, fait passer le flux de connexion par cloudscraper, génère le code à double facteur à la volée, et récupère un jeton OAuth qu'il écrit ensuite dans un fichier.
Au niveau des identifiants, c'est l'hébergeur de l'instance qui les fournit puisque depuis la coupure de 2024, faire tourner Nitter imposait de le relier à un vrai compte X. On est donc très loin du robot anonyme qui lit une page publique. C'est un client officiel simulé, avec des identifiants valides, et c'est exactement ça que la lettre de mise en demeure décrit.
Donc voilà, le problème est bien plus compliqué que du scraping simple. Ce sera donc à un juge de trancher sur le fond.
Depuis,
le dépôt GitHub
est passé en lecture seule, archivé et selon Zedeus, d'autres instances ont reçu des courriers du même genre. De son côté, X ne s'est pas encore exprimé publiquement sur cette affaire.
Reste la question qui nous intéresse : On fait comment pour lire la merde fasciste de X sans compte maintenant ? Bah honnêtement, y'a pas grand-chose... Moi, je vous recommande d'arrêter d'aller là-dessus pour votre propre bien-être. Mais si vraiment vous êtes accro, le
pont ActivityPub bird.makeup
répond toujours présent et permet de suivre un compte X public depuis Mastodon. Toutefois, il ne vous affichera pas un fil de discussion direct dans le navigateur comme le faisait XCancel ou Nitter.
Après pour un post précis, il reste éventuellement la Wayback Machine, à condition que quelqu'un ait archivé le tweet avant. Sinon, bah faudra vous reconnecter sur X à l'ancienne avec votre compte...
Vous êtes à la recherche d’une solution de retopologie simple et gratuite ? AutoRemesher est peut-être fait pour vous. Ce logiciel multiplateforme est encore jeune, mais propose déjà des fonctions intéressantes. Nous profitons de la sortie de la version 1.1 pour vous le présenter. Développé par Jeremy Hu (dont vous connaissez peut-être déjà l’outilde modélisation […]
Jonathan Blow, le développeur de Braid et de The Witness, a annoncé hier (le 12 août) sur X qu'il laissait tomber VLC... La raison c'est 33 putain de secondes d'attente entre un clic sur un fichier MP3 et le début de la lecture, sous Windows (évidement). C'est vrai qu'une demi-minute pour lancer un son sur une machine récente, c'est abusé ! Du coup, il est repassé au bon vieux lecteur multimédia de Microsoft.
Son point de vue c'est que "tout un secteur du logiciel open source est dans un état franchement embarrassant" dès qu'il s'agit de tourner Windows. Je peux pas lui donner tord, c'est vrai que le ralentissement est réel sous Windows 11, sans qu'on sache vraiment pourquoi...
Mais heureusement,
la réponse de VideoLAN
ne s'est pas faite attendre et a replacé correctement le débat. Pour l'équipe de VLC, la lenteur vient d'un bug de Microsoft Defender arrivé avec une mise à jour de Windows 11, qui a mis le cache de plugins de VLC en quarantaine. L'antivirus maison de Windows a donc classé comme suspect, puis mis de côté, un fichier que VLC génère lui-même. VideoLAN écrit qu'il s'est retrouvé là "comme par magie".
Pour remettre VLC d'aplomb, VideoLAN propose donc de réinstaller le logiciel ou de régénérer ce cache. Mais pas besoin d'aller jusqu'à la réinstallation, puisque l'installeur Windows officiel dispose déjà d'un raccourci qu'il faut dans le dossier VideoLAN du menu Démarrer, "VLC media player - reset preferences and cache files".
Ce raccourci lance vlc.exe avec les deux options de remise à zéro, la configuration et le cache de plugins, puis referme aussitôt le lecteur. Ça devrait faire le taf même si attention, vos préférences partent aux chiottes avec le reste, donc si vous avez bricolé vos réglages de sortie audio, vos raccourcis clavier ou vos sous-titres, vous les perdrez. Mais ensuite, le cache, lui, se reconstruira au lancement suivant.
Après régénérer le cache n'empêche pas Defender de le rechoper par la suite. L'autre option, c'est donc d'exclure une bonne fois pour toutes vlc.exe de la liste d'analyse de l'antivirus.
Bref, ce genre de faux positif n'est pas nouveau chez Windows Defender, qui y'a pas longtemps a même pris des certificats DigiCert pour un cheval de Troie, sans parler des
ISO Linux qui se font flagger régulièrement
.
Voilà, hormis la comm de VLC pour le moment, personne n'a encore publié de détails techniques, et Microsoft n'a rien dit.
Depuis ce printemps, sachez qu'un git clone ordinaire peut maintenant récupérer un dépôt qui n'existe sur aucun serveur spécifique. En fait, le code est stocké dans Freenet, le réseau pair-à-pair qu'Ian Clarke a relancé en mars. Et comme y'a plus d'hébergeur, bah y'a plus personne pour fermer un compte ou shooter le dépôt.
Car Git est décentralisé depuis toujours et fonctionne très bien comme ça, puisque chaque clone contient l'historique complet, ce qui permet à 2 clones de se synchroniser directement. Ce qui lui manquait par contre, c'était l'hébergement, et c'est là-dessus que les forges que nous connaissons, Github en tête, sont venues capitaliser. Y'a bien des initiatives comme
Grasp qui essaie d'en sortir grâce au protocole Nostr
mais
freenet-git
lui range carrément le dépôt dans un contrat que les nœuds recopient, et se publie lui-même à l'adresse freenet::99TmCayXn6Tm/freenet-git.
Cloner ou publier du code exige donc le paquet freenet-git et un nœud qui tourne sur votre machine, ce qui fait qu'on ne supprime pas vraiment le serveur, mais on le ramène juste chez soi.
Le socle compte plus que l'application dans cette présentation. Les contrats et les delegates forment la couche où une app tourne sans backend, et quatre tournent déjà dessus : River pour le chat de groupe, Delta pour les sites, Atlas pour la recherche, et freenet-git pour le code. Mail, Raven et Harvest existent aussi, à un stade plus jeune.
L'adresse du dépôt sort des 12 premiers caractères de la clé publique de son propriétaire, et à ce stade expérimental, lui seul peut pousser dedans. Y'a pas non plus de pull requests, ni d'issues puisque c'est le modèle du noyau Linux d'avant les forges, où chacun publie son clone et le mainteneur vient y piocher ce qui l'intéresse.
Reste le plus dur maintenant, retrouver un dépôt.
Car sans annuaire, un nœud doit deviner lequel de ses voisins mettra le moins de temps à trouver ce qu'on lui demande. Le réseau traite ça comme un problème d'apprentissage et parie sur le bon voisin à partir des requêtes passées grâce à Renegade, une bibliothèque open source sortie en 2021, capable de faire ce calcul.
Installer freenet-git
Il faut une chaîne Rust, et ~/.cargo/bin doit être dans votre PATH. Les installeurs du nœud sont sur freenet.org/quickstart.
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
Rust n'entre dans le PATH qu'au shell suivant, donc ouvrez un nouveau terminal avant la commande d'après. Elle dépose deux binaires, freenet-git et le remote helper que Git appellera tout seul.
cargo install freenet-git
Cloner un dépôt qui existe déjà
Aucune identité n'est nécessaire pour lire. La bibliothèque standard de Freenet fait un bon test, elle porte son historique complet et ses tags.
git clone freenet::96rknpy1GYhZ/freenet-stdlib
Publier le vôtre
C'est create qui publie réellement le contrat. Il affiche PUT confirmed by host et l'adresse du dépôt, dont le préfixe se recopie dans le remote. La phrase de passe voyage par une variable d'environnement parce que Git garde la main sur l'entrée standard durant le push.
Et voilà ! Avec ça vous pouvez faire du vrai git décentralisé même si la vraie limite est ailleurs...
En effet, les nœuds gardent en cache ce qu'on leur réclame et évacuent le reste, donc un dépôt que personne ne clone finit au bout d'un moment par ne plus être clonable. Et ça c'est dommage... C'est pourquoi une commande (rescue), le remet en circulation depuis une machine qui a encore les données. Le projet ne présente toutefois pas ça comme un bug, mais comme son modèle de durabilité actuel.
Mais autant le savoir avant d'y déposer votre code.
Vous jouez sous Linux et votre bibliothèque Steam, GOG ou Epic tourne à peu près entièrement grâce à
Proton
? Cela signifie que, malheureusement, vos jeux Xbox PC et ceux du Game Pass, eux, restent à la porte... C'est con d'avoir un catalogue entier, payé tous les mois rubis sur l'ongle et de ne pas pouvoir y toucher ailleurs que sous Windows, via le streaming cloud.
Mais cette époque est révolue puisque Xodus est un projet open source qui rétro-ingénierie la chaîne Xbox PC pour faire tourner ces jeux directement sur Linux. Son dépôt coche déjà la connexion de l'appareil, celle du compte, l'autorisation Xbox, la récupération des licences, le téléchargement des paquets de jeu et le déchiffrement des exécutables à la demande. Bref, la douane est passée (non pas Hamza, celle de Microsoft).
Ce qui bloquait n'a jamais été Proton puisqu'en fait un jeu Xbox PC moderne repose sur le GDK de Microsoft et arrive emballé dans un conteneur MSIXVC chiffré, dont les clés dépendent de la licence attachée au compte.
Rien à voir donc avec un .exe posé dans un dossier.
L'équipe, emmenée par Paweł Lidwin qui contribue aussi à
Heroic
, a donc dû fabriquer ses propres briques, une bibliothèque d'authentification Xbox, un lecteur capable de parcourir ces conteneurs, et surtout une réimplémentation libre de xgameruntime.dll, le composant par lequel les jeux réclament les services Xbox (Celle-là est toujours en chantier). Le projet entretient même ses propres versions modifiées de Wine et de Proton.
Sauf qu'on ne joue toujours pas... Aucun binaire n'est distribué, il faut tout compiler soi-même, et les fameux services Xbox doivent encore être servis aux jeux à travers Wine. Le lancement, c'est donc le gros morceau restant même si un jeu auquel vous avez droit se récupère et se déchiffre.
Côté catalogue, il faut du GDK et du MSIXVC. Le MSIXVC2 n'est pas géré, Gears of War 4 reste sur le carreau, et les titres rétrocompatibles se récupèrent mais réclameront peut-être des correctifs dans wine ou dxvk. Quant au déchiffrement, il s'appuie sur les instructions AES du processeur. Cela signifie que sur une machine trop vieille pour les avoir, ça ne ramera même pas... ça s'arrête juste net sur une instruction "illegal".
Et puis, vous vous en doutez, il y a Microsoft... Le projet n'est ni affilié ni approuvé par Redmond, donc c'est à utiliser à vos risques et périls, car rien n'empêche l'éditeur de changer une clé ou de modifier un bout du protocole et de refermer la porte du jour au lendemain. Avec Xodus, personne n'a rien promis, et c'est un pari sur un avenir incertain... Toutefois le
dépôt
avance bien quand même, sans binaire à la clé pour le moment.
Cloudflare Computer
est un projet qui donne à votre agent IA un endroit rien qu'à lui. C'est-à-dire un vrai système de fichiers, avec des dossiers, des fichiers qui restent, et de quoi lancer des commandes dedans. Bref, un vrai poste de travail que l'agent garde entre deux sessions, au lieu de repartir de zéro à chaque fois, puisque tous les fichiers sont rangés dans une base SQLite.
Le système de fichiers s'utilise ensuite comme n'importe quel autre. Lire, écrire, créer un dossier, lister, supprimer, et un grep intégré pour fouiller dans le tas. Pour tout le reste, il n'y a qu'une fonction à retenir, exec(). Vous lui passez une commande, et elle vous rend la sortie et le code de retour.
Ce qui change par contre, c'est l'endroit où la commande tourne. 3 environnements sont disponibles et interchangeables sur les mêmes fichiers. Il y a d'abord un conteneur Linux complet, avec npm, node et de vrais binaires. Ou un shell léger pour les commandes simples. Et enfin, un dernier qui exécute directement votre code, sur une base neuve à chaque appel.
Comme ça, vous passez de l'un à l'autre sans réécrire une ligne de votre agent.
Les 9 exemples fournis montrent bien ce qu'on peut en tirer quand on aime bidouiller. Le plus parlant fait par exemple tourner un agent de discussion qui prendra l'espace de travail comme répertoire courant, donc qui travaillera dans de vrais fichiers au lieu de tout garder en mémoire.
Un autre colle
pandoc
dans le conteneur et laisse l'agent transformer une fiche markdown en PDF. Il y en a aussi un qui fabrique des images avec Workers AI, un quatrième joue sur les politiques de sortie réseau pour décider ce que l'agent a le droit de joindre, et enfin, un dernier génère un projet Worker complet, puis le publie.
Il y a même une interface web qui balance la même tâche dans le conteneur et dans un environnement léger, côte à côte.
Reste à savoir ce qui est gratuit là-dedans... Le code est sous licence MIT, et le système de fichiers seul, sans aucune exécution, tourne sans souci dans le plan Workers gratuit puisque les Durable Objects qui portent ce stockage y sont inclus, avec 100 000 requêtes par jour et 5 Go d'espace.
Il faut un compte Cloudflare, évidemment...
Puis si vous voulez faire tourner des vraies commandes ou avoir un shell, faudra payer puisque le conteneur comme les environnements légers réclament le plan Workers payant, facturé 5 dollars par mois au minimum.
Après j'ai quelques réserves quand même parce que le projet est très récent, encore en preview et clairement inadapté à de la production. Ensuite, la limite technique d'un espace de travail tourne autour de 10 Go, et les accès disque lourds restent plus lents que sur un vrai disque. Puis surtout, tout vit chez Cloudflare, et pas chez vous (si vous préférez l'inverse,
je vous avais montré workerd
, le moteur des Workers en local).
Mais bon, c'est à garder à l'œil si vous êtes client Cloudflare.

 Connexion